LLM 활용
AI 검증자의 지적을 그대로 고치면 안 되는 이유
검증 레인이 돌려준 지적을 그대로 고치면 검증자의 실수가 그대로 얹힌다. 위치·부재·논리 세 종류로 나눠 원본 대조와 근거 판정으로 채택 여부를 가르는 절차를 정리했다.
카테고리
LLM 활용 글은 모델 소개가 아닙니다. 여러 도구를 한 작업에 연결했을 때 표시된 이름과 실제 호출이 다르거나, 병렬로 나눈 구간이 서로 다른 사실을 말하거나, 검증자의 지적을 그대로 반영하면 원본이 더 나빠지는 경우를 다룹니다.
설정에 적은 모델 ID가 더 가벼운 모델로 조용히 바뀐 사건, 9,402건 로그를 여섯 구간으로 나눠 결론이 갈린 분석, 검증 레인 지적을 원문과 대조하지 않고 고치면 안 되는 이유가 이 갈래의 중심입니다. 도구 이름만 바꿔 같은 조언을 반복하지 않고, 그 실행에서 확인한 불일치만 적습니다.
프롬프트 모음이나 순위표는 발행하지 않습니다. 독자가 같은 실패를 가리려면 입력, 출력, 판정 기준이 글 안에 있어야 합니다.
검증 레인이 돌려준 지적을 그대로 고치면 검증자의 실수가 그대로 얹힌다. 위치·부재·논리 세 종류로 나눠 원본 대조와 근거 판정으로 채택 여부를 가르는 절차를 정리했다.
대화 로그 9,402건을 시간순 6분할로 병렬 위임한 이번 작업에서는 구간 사이의 맥락이 끊겨 워커 결론이 엇갈렸다. 상충은 원문 재검토로 풀었고, 원인은 인용문을 본인 진술로 오독한 것이었다.
브리프에 규칙과 예시를 함께 적었더니 둘이 충돌했다. 에이전트는 둘 다 만족시키는 구현을 택했고, 그 과정에서 산출물 순서가 갈라졌다.
도구가 300초씩 멈추는 버그를 두 번이나 엉뚱한 원인으로 오판했다. 권한 플래그와 모델 티어를 차례로 의심했지만 진짜 원인은 하위 프로세스에 전달하지 않은 표준 입력이었다.
AI 코딩 에이전트를 쓸 때 이 작업을 직접 처리할지 서브에이전트에 위임할지 가르는 네 가지 신호와 비용 교차점, 실제 판정 사례를 정리했다.
Claude Code의 Bash 도구를 기준으로 입력 스키마, 권한 패턴, PreToolUse 훅, 실행 결과가 스키마·프롬프트·권한·실행·UI로그·기능 게이트 6가지 계약으로 이어지는 방식을 설명한다.
AI로 애드센스 글을 쓸 때 가짜 수치·경험을 지어내면 왜 위험한지, 한국어 어미 단조는 끝 어절로 봐야 하는 이유, 발행 전 다섯 단계 검증 게이트를 정리한다.
검증 결과 파일에 적힌 모델 이름과 실제로 호출된 모델이 다를 수 있다. 잘못된 슬러그가 조용히 다른 모델로 대체된 사례로 표시명 대신 실행 로그를 확인하는 법을 정리했다.
AI 코딩 에이전트 비용이 새는 이유는 호출 가격이 아니라 예산창·귀속·예외 워크플로우 설계 부재다. LangChain의 LLM Gateway 사례로 실전 비용 통제 프레임워크를 정리한다.
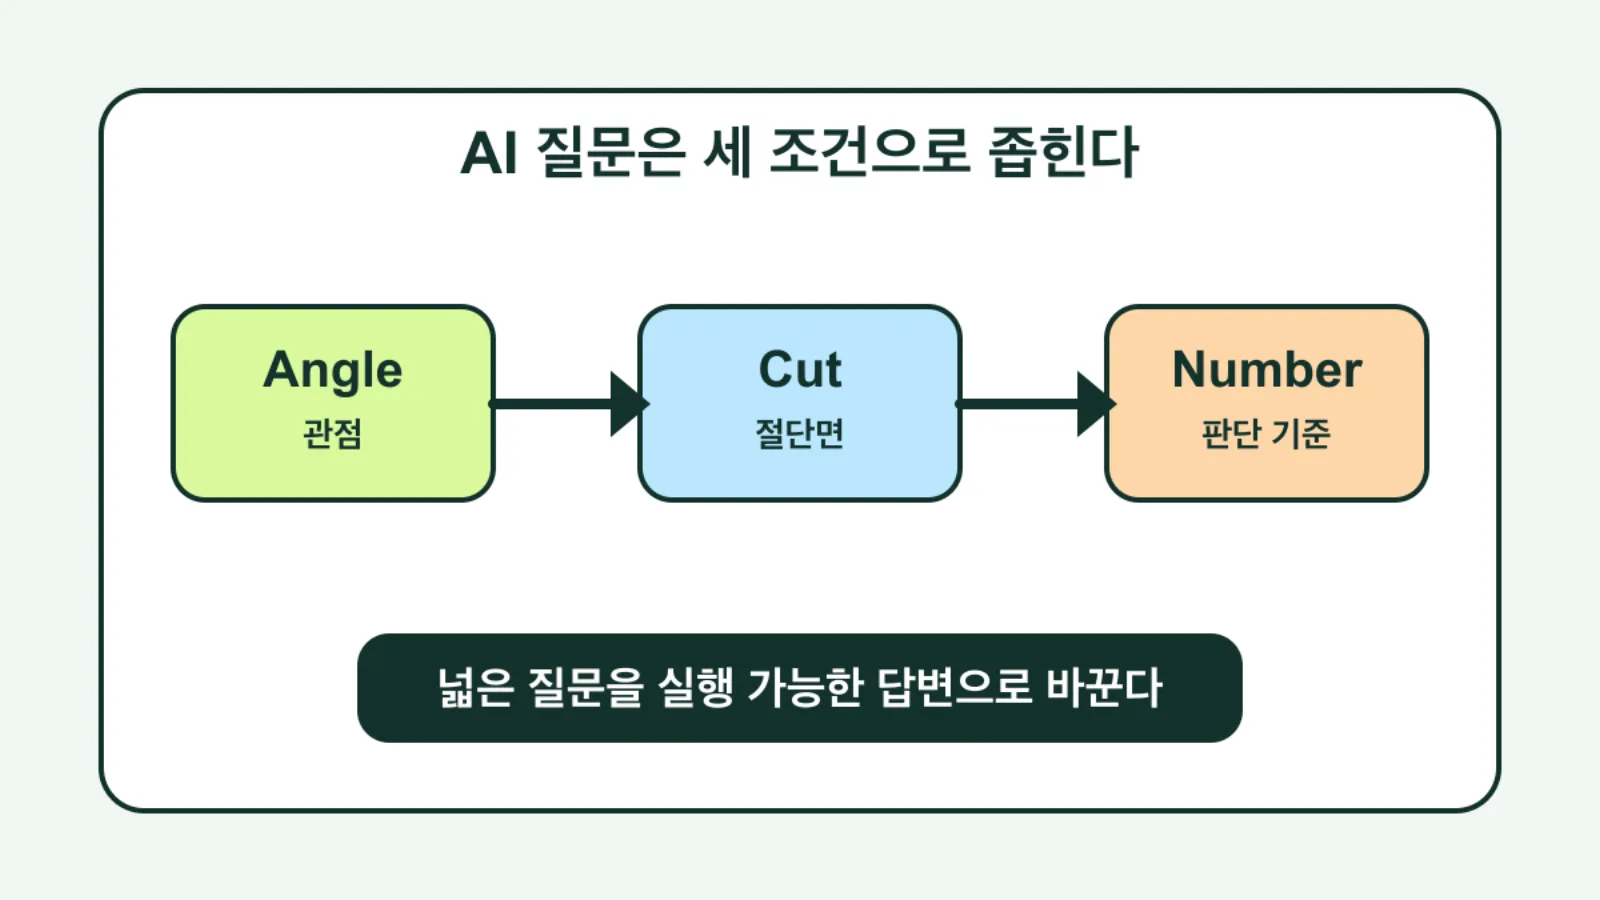
LLM 답변이 흐릿하다면 모델보다 질문 구조를 먼저 봐야 한다. 관점, 절단면, 숫자를 넣어 바로 쓸 답을 끌어내는 방법.
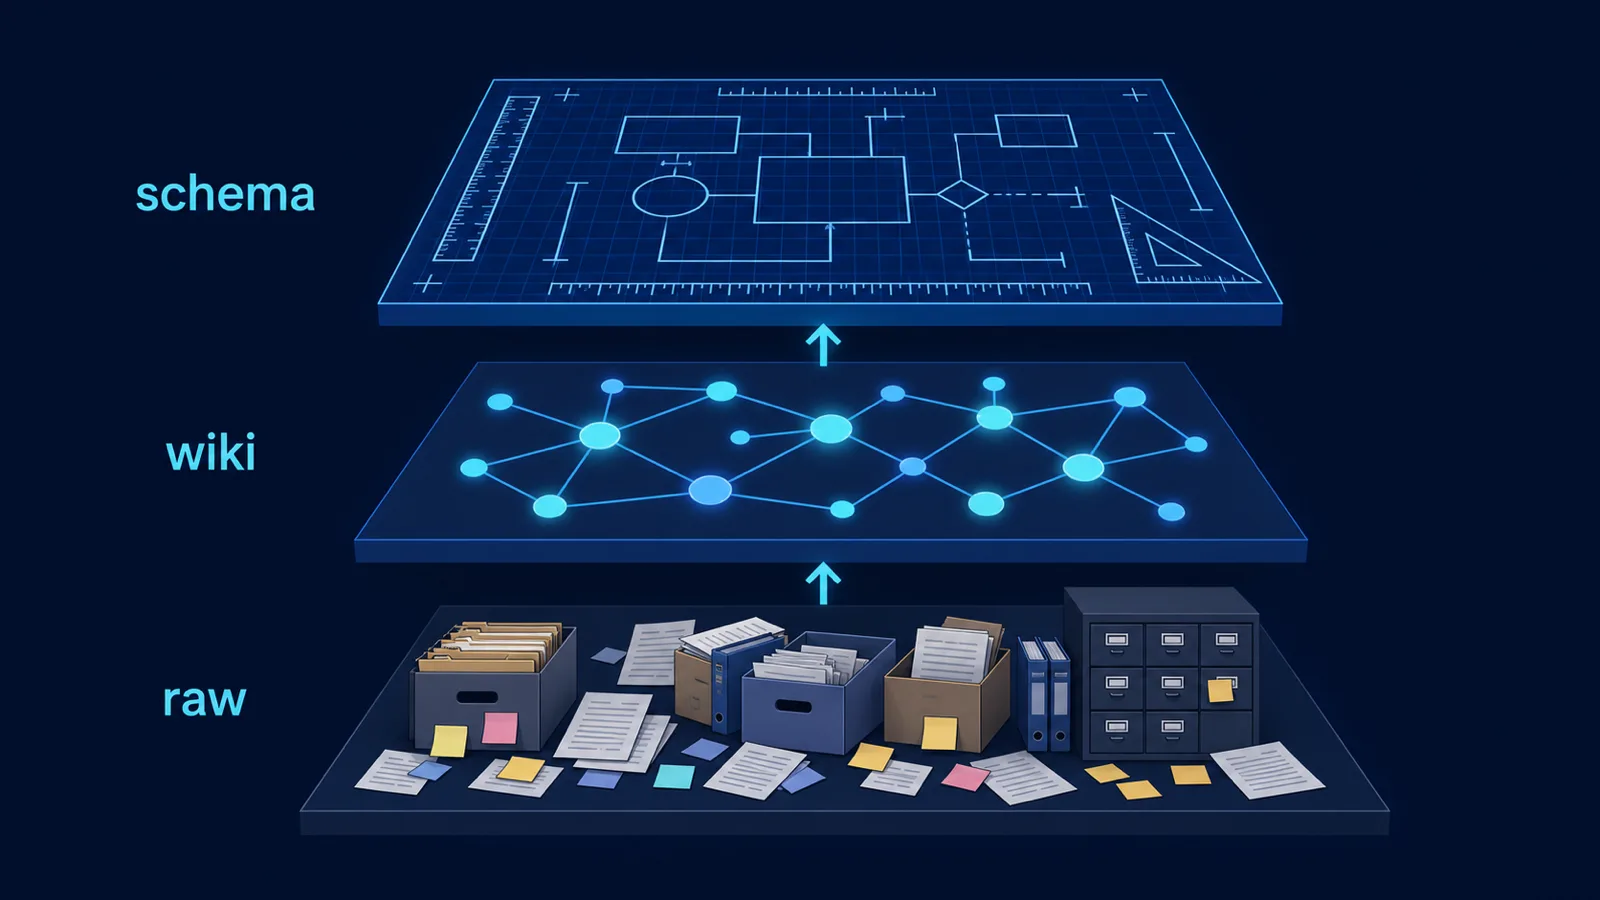
원자료가 5,000개를 넘어가면 전부 다시 읽을 수 없다. raw는 원문 창고로, wiki는 LLM이 압축해 다시 쓰는 지도로 나누자 검색이 되살아났다.
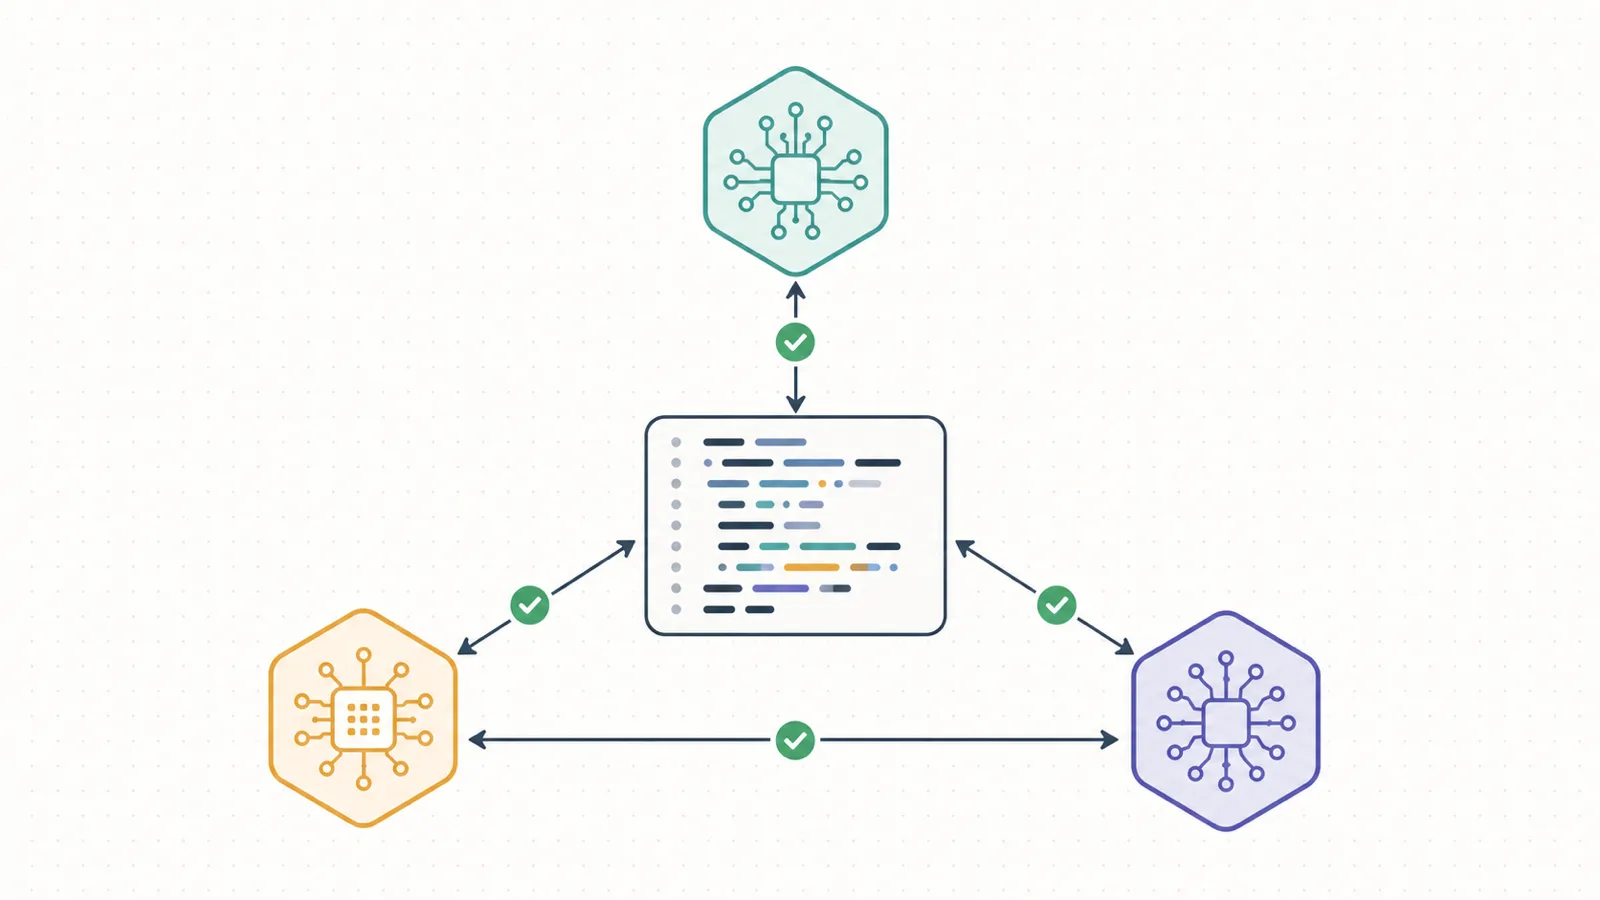
AI가 쓴 코드를 같은 모델로 검토하면 자기 실수를 놓친다. 작성자와 다른 벤더가 계획·테스트·구현을 단계마다 교차 검증하고, 근거가 비면 통과 대신 실패로 처리한다.
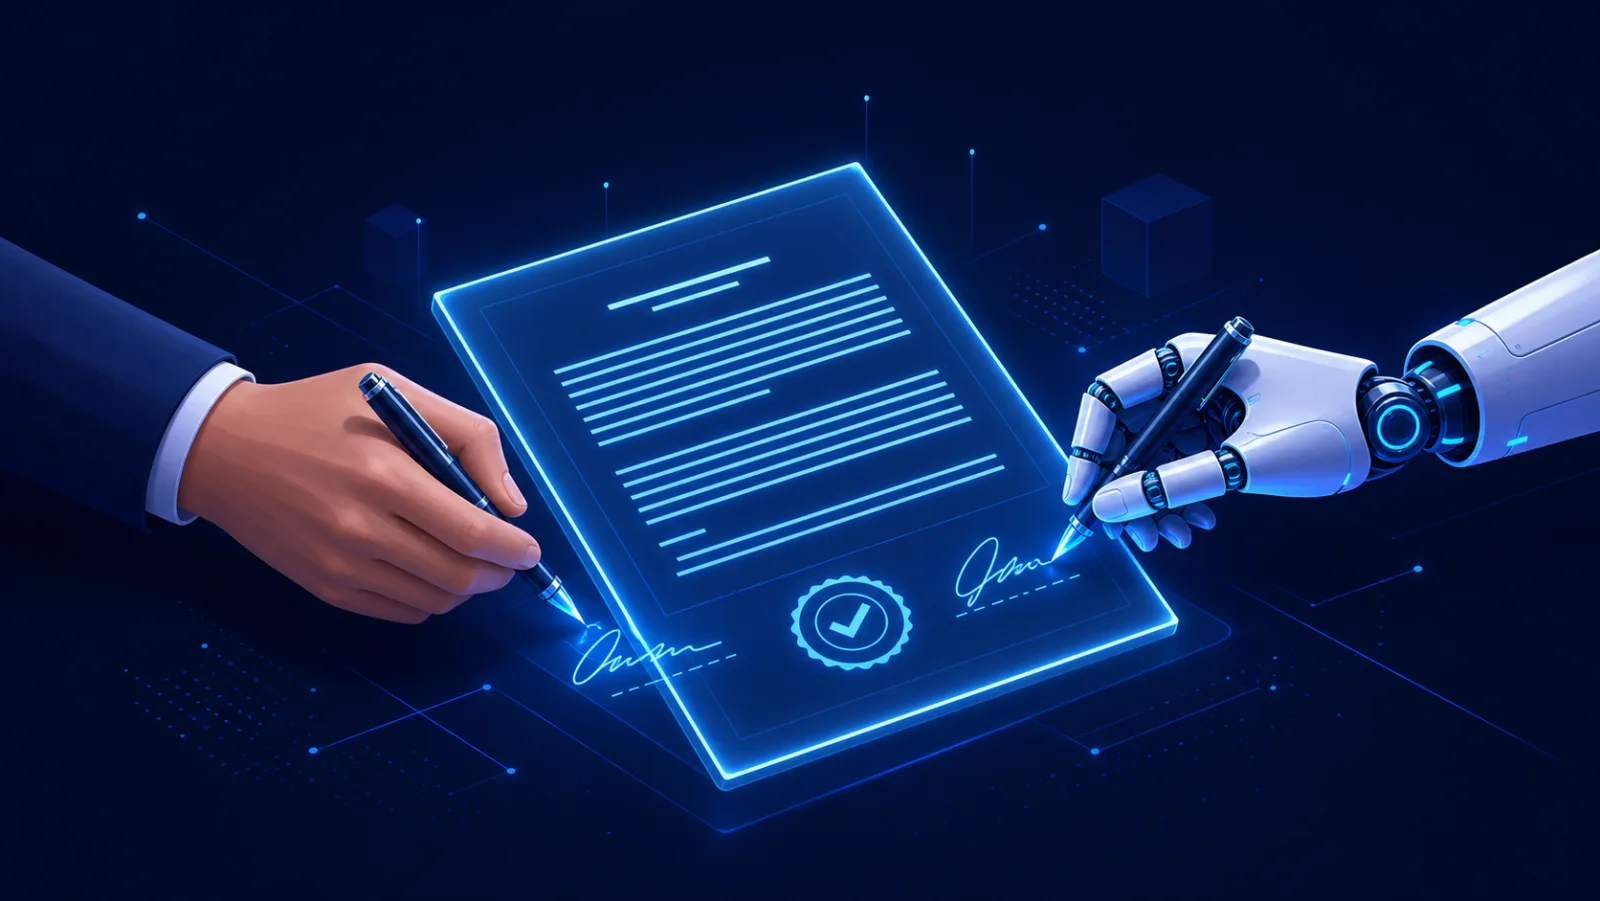
AI 에이전트에게 작업을 맡기기 전, 프롬프트 문장보다 먼저 정해야 할 건 계약 구조다. 목표·문맥·범위·제약·검증·인계 6가지와 위임 4단계를 실전 프레임워크로 정리했다.
1년 넘게 Claude Code를 쓰는 개발자가 미니멀 하네스 Pi를 항목별로 비교한다. 흉내 낼 수 있는 부분과 구조적으로 안 되는 부분을 가르고, 여전히 Claude Code Max 20을 쓰는 이유를 적는다.