대화 로그 9,402건을 6분할 병렬 분석했더니 결론이 갈린 이유
대화 로그가 9,402건이었다. 기간은 보름 남짓, 파일 하나에 다 들어 있었다. 한 에이전트에게 처음부터 끝까지 순서대로 읽히면 뒷부분을 볼 즈음엔 앞부분 맥락이 이미 흐려진다. 요약만 뽑는 작업이면 그래도 버틸 만한데, 이번엔 원문 문장을 하나하나 대조해야 하는 성격의 작업이라 더 버티기 어려웠다.
대화 로그(메신저 대화를 통째로 내보낸 텍스트 파일, export)를 그대로 한 컨텍스트 창에 밀어 넣는 방법부터 시도했다. 되긴 하는데 뒤로 갈수록 앞에서 나온 내용을 다시 물어봐야 했다. 그때마다 처음부터 다시 훑는 건 아니었지만, 앞뒤를 오가며 확인하는 과정이 반복됐다. 이번 작업에서는 이 반복 때문에 순차 처리를 계속하지 않았다.
결국 방향을 바꿨다. 한 에이전트에게 통으로 맡기는 대신 여러 에이전트에 나눠 맡기기로 했다. 이 선택으로 여섯 구간을 동시에 시작할 수 있었지만, 전혀 예상 못 한 문제 하나도 드러났다. 그 문제를 발견하고 원인을 찾고 고치기까지의 과정을 여기 그대로 남긴다.
대화 로그 9,402건, 한 번에 못 읽는 분량이었다
9,402건을 한 에이전트가 순서대로 읽고 정리하면 얼마나 걸릴지 가늠해 봤다. 시간이 문제가 아니라 뒤로 갈수록 앞의 맥락을 놓치는 게 더 큰 문제였다. 사람도 긴 문서를 한 번에 다 읽고 나서 세부 사항을 전부 기억하지는 못한다. 모델도 컨텍스트가 길어지면 앞쪽 정보의 비중이 흐려지는 현상이 비슷하게 나타났다.
요약만 필요했다면 이 정도 분량도 어떻게든 버텼을 것이다. 이번 작업은 원문 문장 하나하나를 근거로 남겨야 하는 성격이라 요약으로 건너뛸 수 없었다. 요약은 압축하는 과정에서 이미 판단이 한 번 섞인다. 그 판단이 맞는지 확인하려면 결국 원문으로 되돌아가야 하니, 애초에 원문을 그대로 보존한 채 작업을 설계해야 했다.
분량이 아니라 구조가 문제라는 걸 알아채는 데 시간이 좀 걸렸다. 처음엔 그냥 컨텍스트가 부족한 탓이라 여겼다. 다시 보니 진짜 문제는 순서였다. 앞에서 나온 대화의 세부 내용을 뒤에서 다시 참조해야 하는 경우가 자주 있었는데, 순차로 읽으면 그 참조가 끊긴다.
이 문제를 여러 구간의 동시 진행으로 풀고 싶었다. 한 에이전트가 순서대로 다 보는 대신, 여러 에이전트가 각자 구간을 맡으면 동시에 시작할 수 있고 워커 하나가 감당할 분량도 줄어든다. 다만 순차 처리와 실제 시간을 비교해 재지는 않았다. 문제는 그다음이었다. 나눈 구간을 다시 하나로 합칠 때 무엇을 잃는지, 이번에 처음으로 제대로 겪었다.
분석 전에 인코딩부터 복구해야 했다
분석에 들어가기 전, 파일을 열어 보니 한글이 다 깨져 있었다. 이번 파일의 깨진 글자(문자가 잘못된 방식으로 해석돼 알아볼 수 없게 나오는 현상, mojibake)는 UTF-8 바이트를 라틴 계열 인코딩(문자를 숫자로 바꿔 저장하는 규칙, encoding)인 latin-1로 잘못 읽은 전형적인 형태였다. 확인한 바이트 패턴도 이 판단과 맞았다.
복구는 간단했다. 잘못 디코드된 문자열을 다시 latin-1로 인코딩해 바이트로 되돌린 다음, 그 바이트를 UTF-8로 다시 디코드하면 원래 한글이 돌아온다.
# 흔한 mojibake 복구 패턴
fixed = broken_text.encode('latin-1').decode('utf-8')
이 한 줄을 확인하지 않고 분석에 들어갔으면 어떻게 됐을까. 워커들이 깨진 텍스트를 원문으로 착각한 채 findings를 낼 위험이 있었다. 인코딩 문제는 뒤로 갈수록 고치기 어려워진다. 워커가 이미 깨진 글자에서 뭔가를 읽어내 결론까지 냈다면, 그 결론을 걷어내고 다시 처음부터 돌려야 하니까. 분석을 시작하기 전에 파일 앞부분 몇 줄을 눈으로 직접 확인하는 습관이 이번에 값을 했다.
복구가 됐는지 확인하는 방법도 따로 정해 뒀다. 파일 앞부분 몇 줄을 사람이 직접 읽어서 자연스러운 한글 문장으로 보이는지 눈으로 대조한다. 자동 검사만 믿지 않는 이유가 있다. 인코딩이 부분적으로만 깨진 경우 프로그램은 오류 없이 그냥 넘어가 버린다. 오류가 안 뜬다고 정상이라는 뜻은 아니었다.
이 확인을 건너뛰고 싶은 유혹도 있었다. 9,402건이나 되는 분량 앞에서 몇 줄짜리 눈 검사는 사소해 보인다. 그런데 이 단계를 건너뛴 채 분석했다면 여섯 워커가 깨진 텍스트를 바탕으로 findings를 냈을 가능성이 있었다. 이번에는 앞단에서 깨짐을 확인한 뒤 복구하고 나서 워커를 실행했다.
시간순 6분할로 나눠 맡긴 대가
인코딩을 복구한 다음, 9,402건을 시간순으로 여섯 조각으로 나눴다. 각 조각을 서로 다른 서브에이전트(메인의 지시를 받아 독립적으로 작업하는 보조 에이전트, subagent)에 동시에 맡겼다. 워커 하나는 자기 구간의 대화만 읽고, 그 구간 안에서 눈에 띄는 내용을 findings 파일 하나로 정리해 돌려주는 구조였다.
워커 하나에게 주는 지시는 단순했다. 자기 구간의 대화만 읽고, 그 안에서 특이하거나 반복되는 내용을 findings 파일로 정리해 돌려 달라는 것이었다. 지시 자체는 문제가 없었다. 문제는 이 지시를 여섯 번 반복하면 여섯 개의 서로 다른 시야가 생긴다는 점이었다.
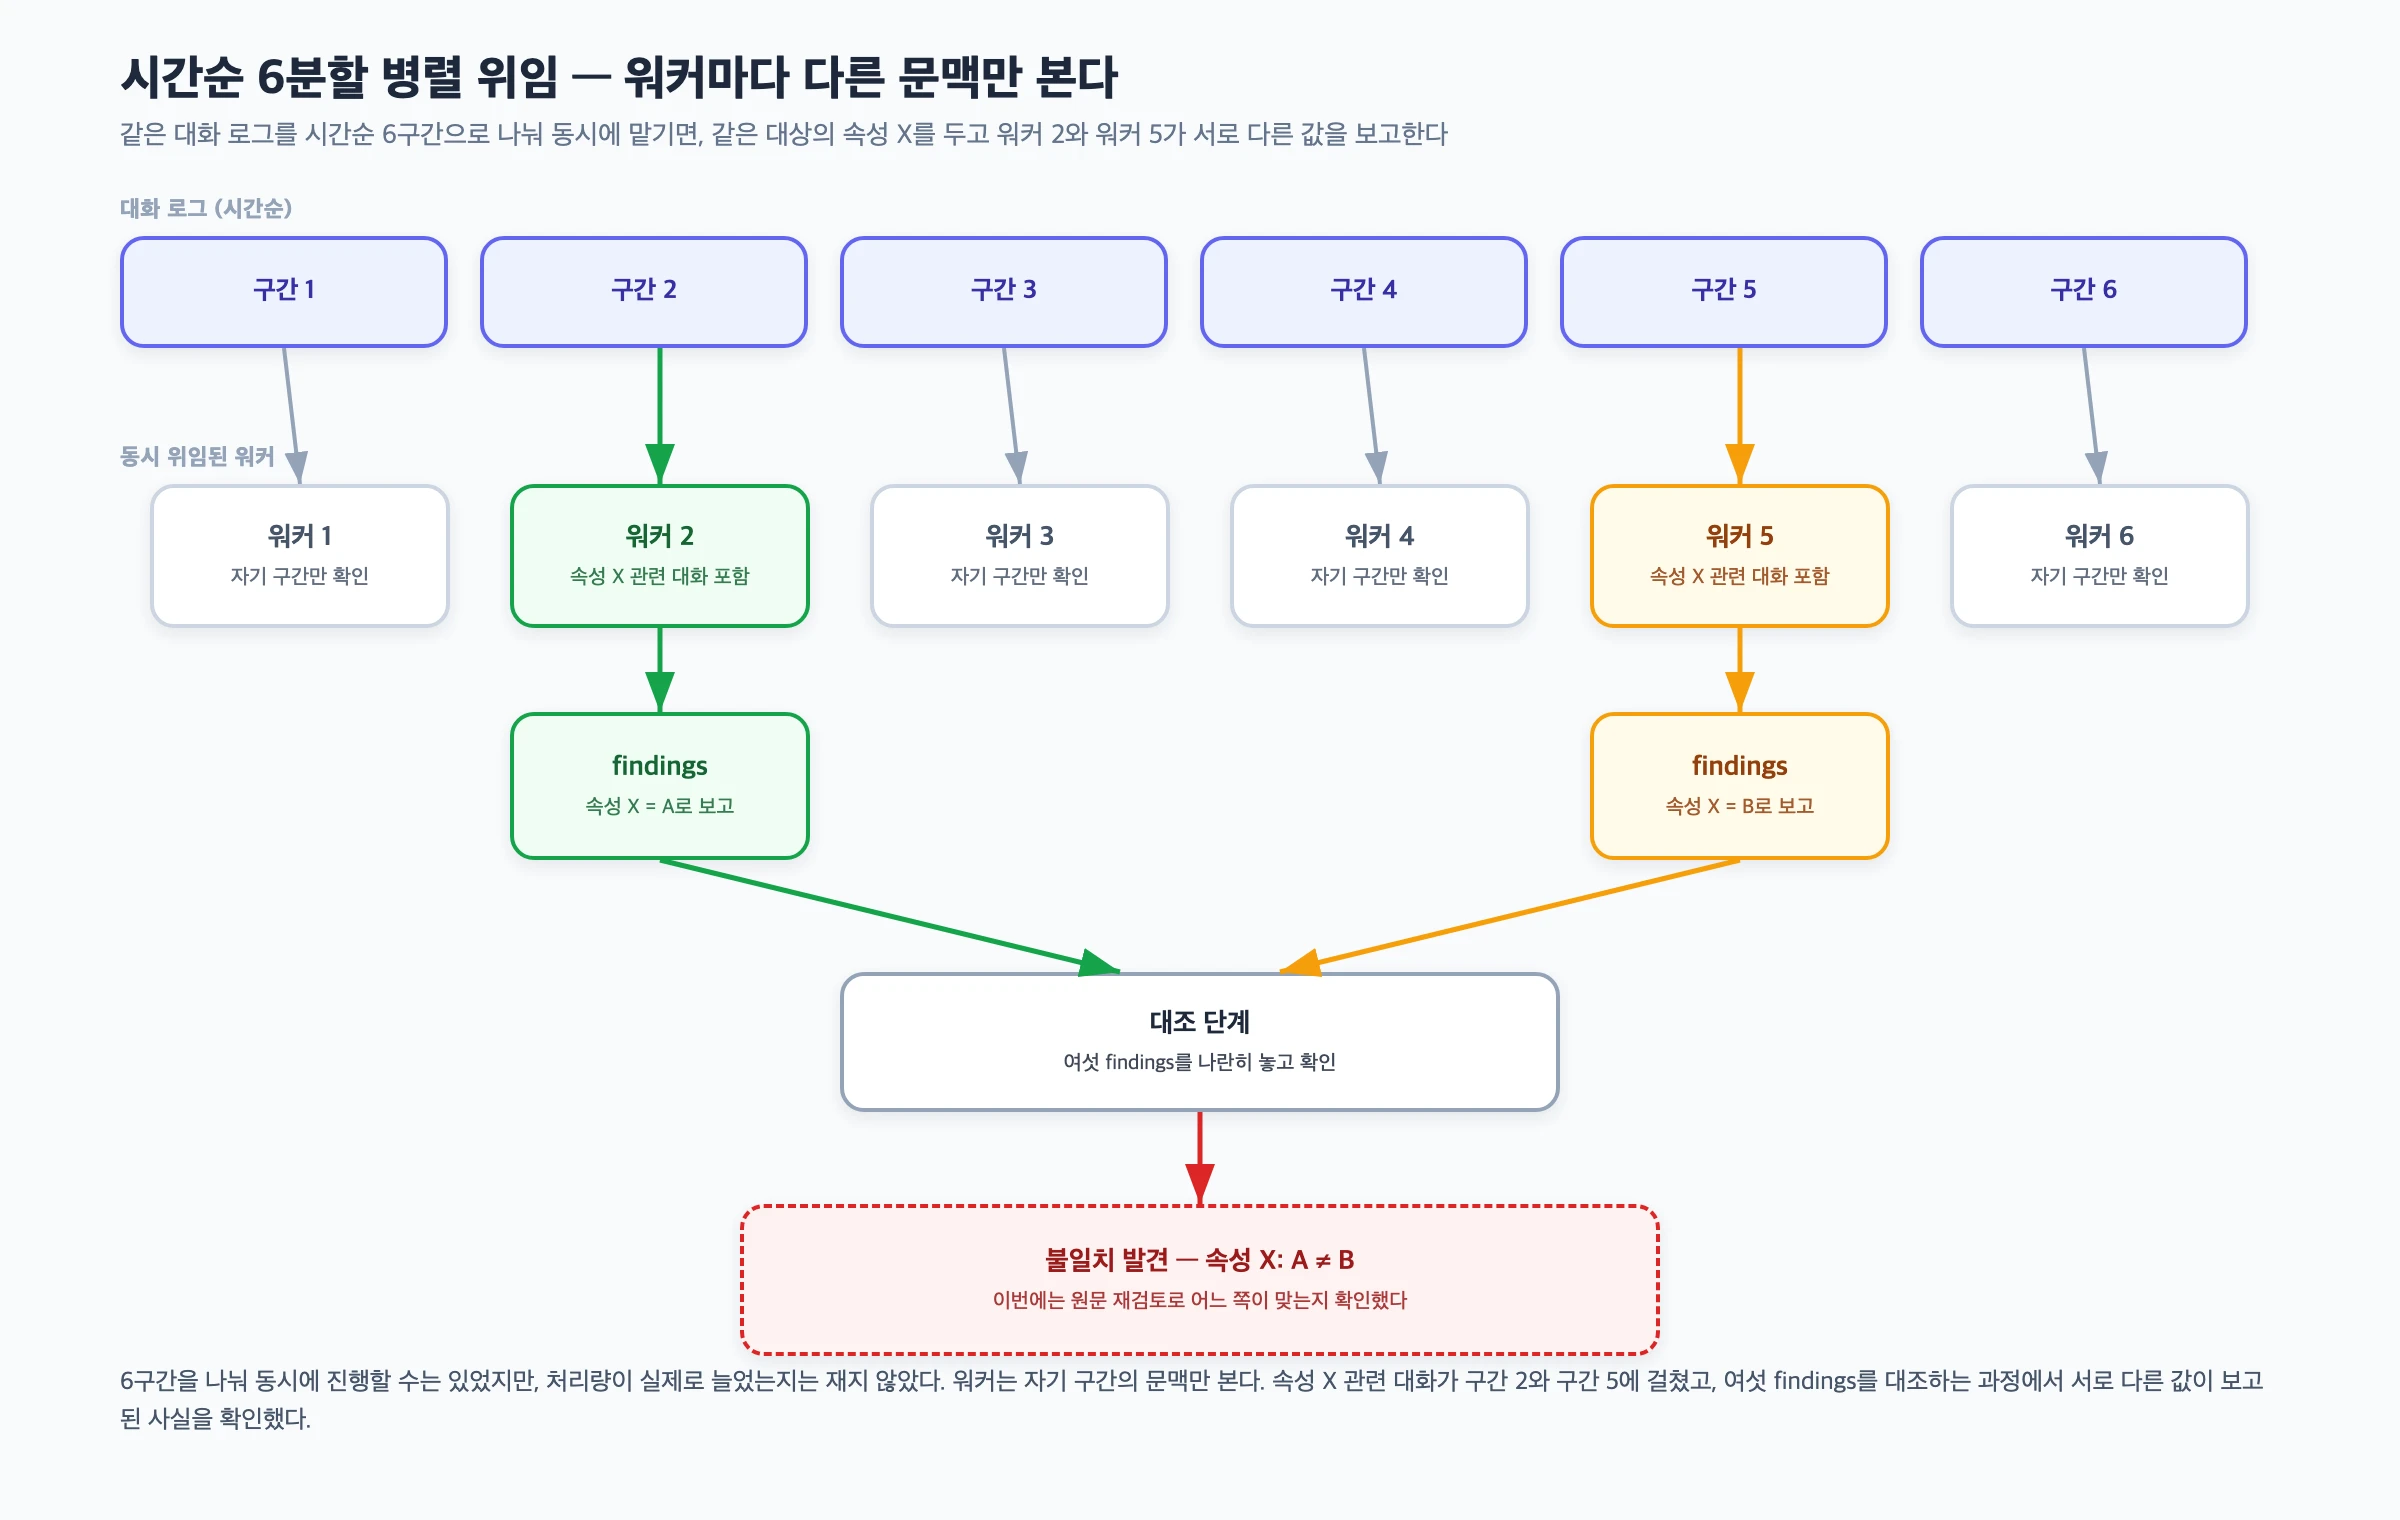
처리 시간을 재지는 않았지만, 여섯 구간을 동시에 진행할 수는 있었다. 순차 읽기와 비교한 속도 차이는 기록하지 않았다. 이번 실행에서 확인된 문제는 워커마다 자기 시간대의 문맥만 봤다는 점이다. 다른 워커가 어떤 대화를 봤는지, 그 안에 어떤 단서가 있었는지는 전혀 모른 채 자기 구간만으로 판단을 내렸다.
이번 결과에서는 워커 하나가 자기 구간에서 본 것과 다른 워커가 자기 구간에서 본 것 사이에 연결 문맥이 빠졌다. 두 findings를 합칠 때 이 연결은 사람이 원문을 다시 읽으며 확인해야 했다.
이 구조에서 실제로 사실 불일치가 나왔다. 같은 대상의 한 속성을 두고 한 워커는 A로 보고했고, 다른 워커는 B로 보고했다. 여섯 개의 findings 파일을 나란히 놓고서야 이 불일치가 눈에 들어왔다. 각 findings를 따로 읽었으면 둘 다 그럴듯하게 보였을 내용이다.
여러 에이전트를 동시에 돌릴 때 겪은 다른 사고 유형은 전에 겪은 사고 사례에서 이미 다뤘다. 그때는 파일이 지워지거나 게이트가 뚫리는 쪽이었다. 이번엔 성격이 달랐다. 무언가 잘못 실행된 게 아니라, 이번 시간순 6분할에서 처리 구간 사이의 맥락이 끊긴 경우였다. 그 결과 워커 간 사실 일관성을 원문으로 따로 확인해야 했다.
상충은 원문 재검토로 풀었다
불일치를 발견하고 나서 제일 먼저 든 생각은 다수결이었다. 여섯 워커 중 넷이 A라고 하면 A를 채택하는 식이다. 아니면 시간상 가장 나중에 나온 워커 결과를 최신 정보로 보고 그걸 그대로 쓰는 방법도 있다. 둘 다 편하지만 둘 다 근거가 없다. 다수결은 다수가 같은 방식으로 틀렸을 가능성을 배제하지 못한다. 최신 채택은 시간 순서가 정확성과 무관하다는 걸 무시한다.
그래서 원문을 직접 grep(파일 안에서 특정 문자열을 찾는 검색 명령, grep)해 대조했다. 상충이 발생한 지점의 원문 대화를 두 워커의 근거와 나란히 펼쳐 놓고 하나씩 짚었다. 이번 상충의 원인은 요약만으로 확인하지 못했지만 원문에는 판단에 필요한 맥락이 남아 있었다.
원인은 하나로 좁혀졌다. 대화 속 인용문이나 제3자에 대한 전언을 워커가 본인 확정 사실로 오독한 경우였다. 누군가 다른 사람의 말을 옮겨 적은 문장을, 그 대화의 화자 본인이 한 말인 것처럼 집계한 셈이다. 원문 전체 맥락을 보면 "누가 한 말인지"가 앞뒤 문장에서 드러나는데, 자기 구간만 보는 워커에게는 그 앞뒤가 없었다.
대조 작업에서는 상충이 발생한 시점 근처의 원문을 시간 순서로 다시 펼쳐 놓고, 두 워커가 각각 무엇을 근거로 그 결론을 냈는지 표시했다. 근거로 삼은 문장을 원문에서 직접 찾아 위아래 몇 줄을 함께 읽으니 어느 결론이 사실과 달랐는지 확인할 수 있었다.
이 과정에서 다시 확인한 사실이 하나 있다. 워커가 내용을 일부러 지어낸 것은 아니지만, 제한된 문맥에서 사실과 다른 결론을 냈다. 자기 구간만 봤을 때는 그럴듯해 보였으나, 결론을 판단하는 데 필요한 맥락이 빠져 있었다. 원문 맥락을 채워 대조하고 나자 그 결론이 틀렸다는 사실이 드러났다.
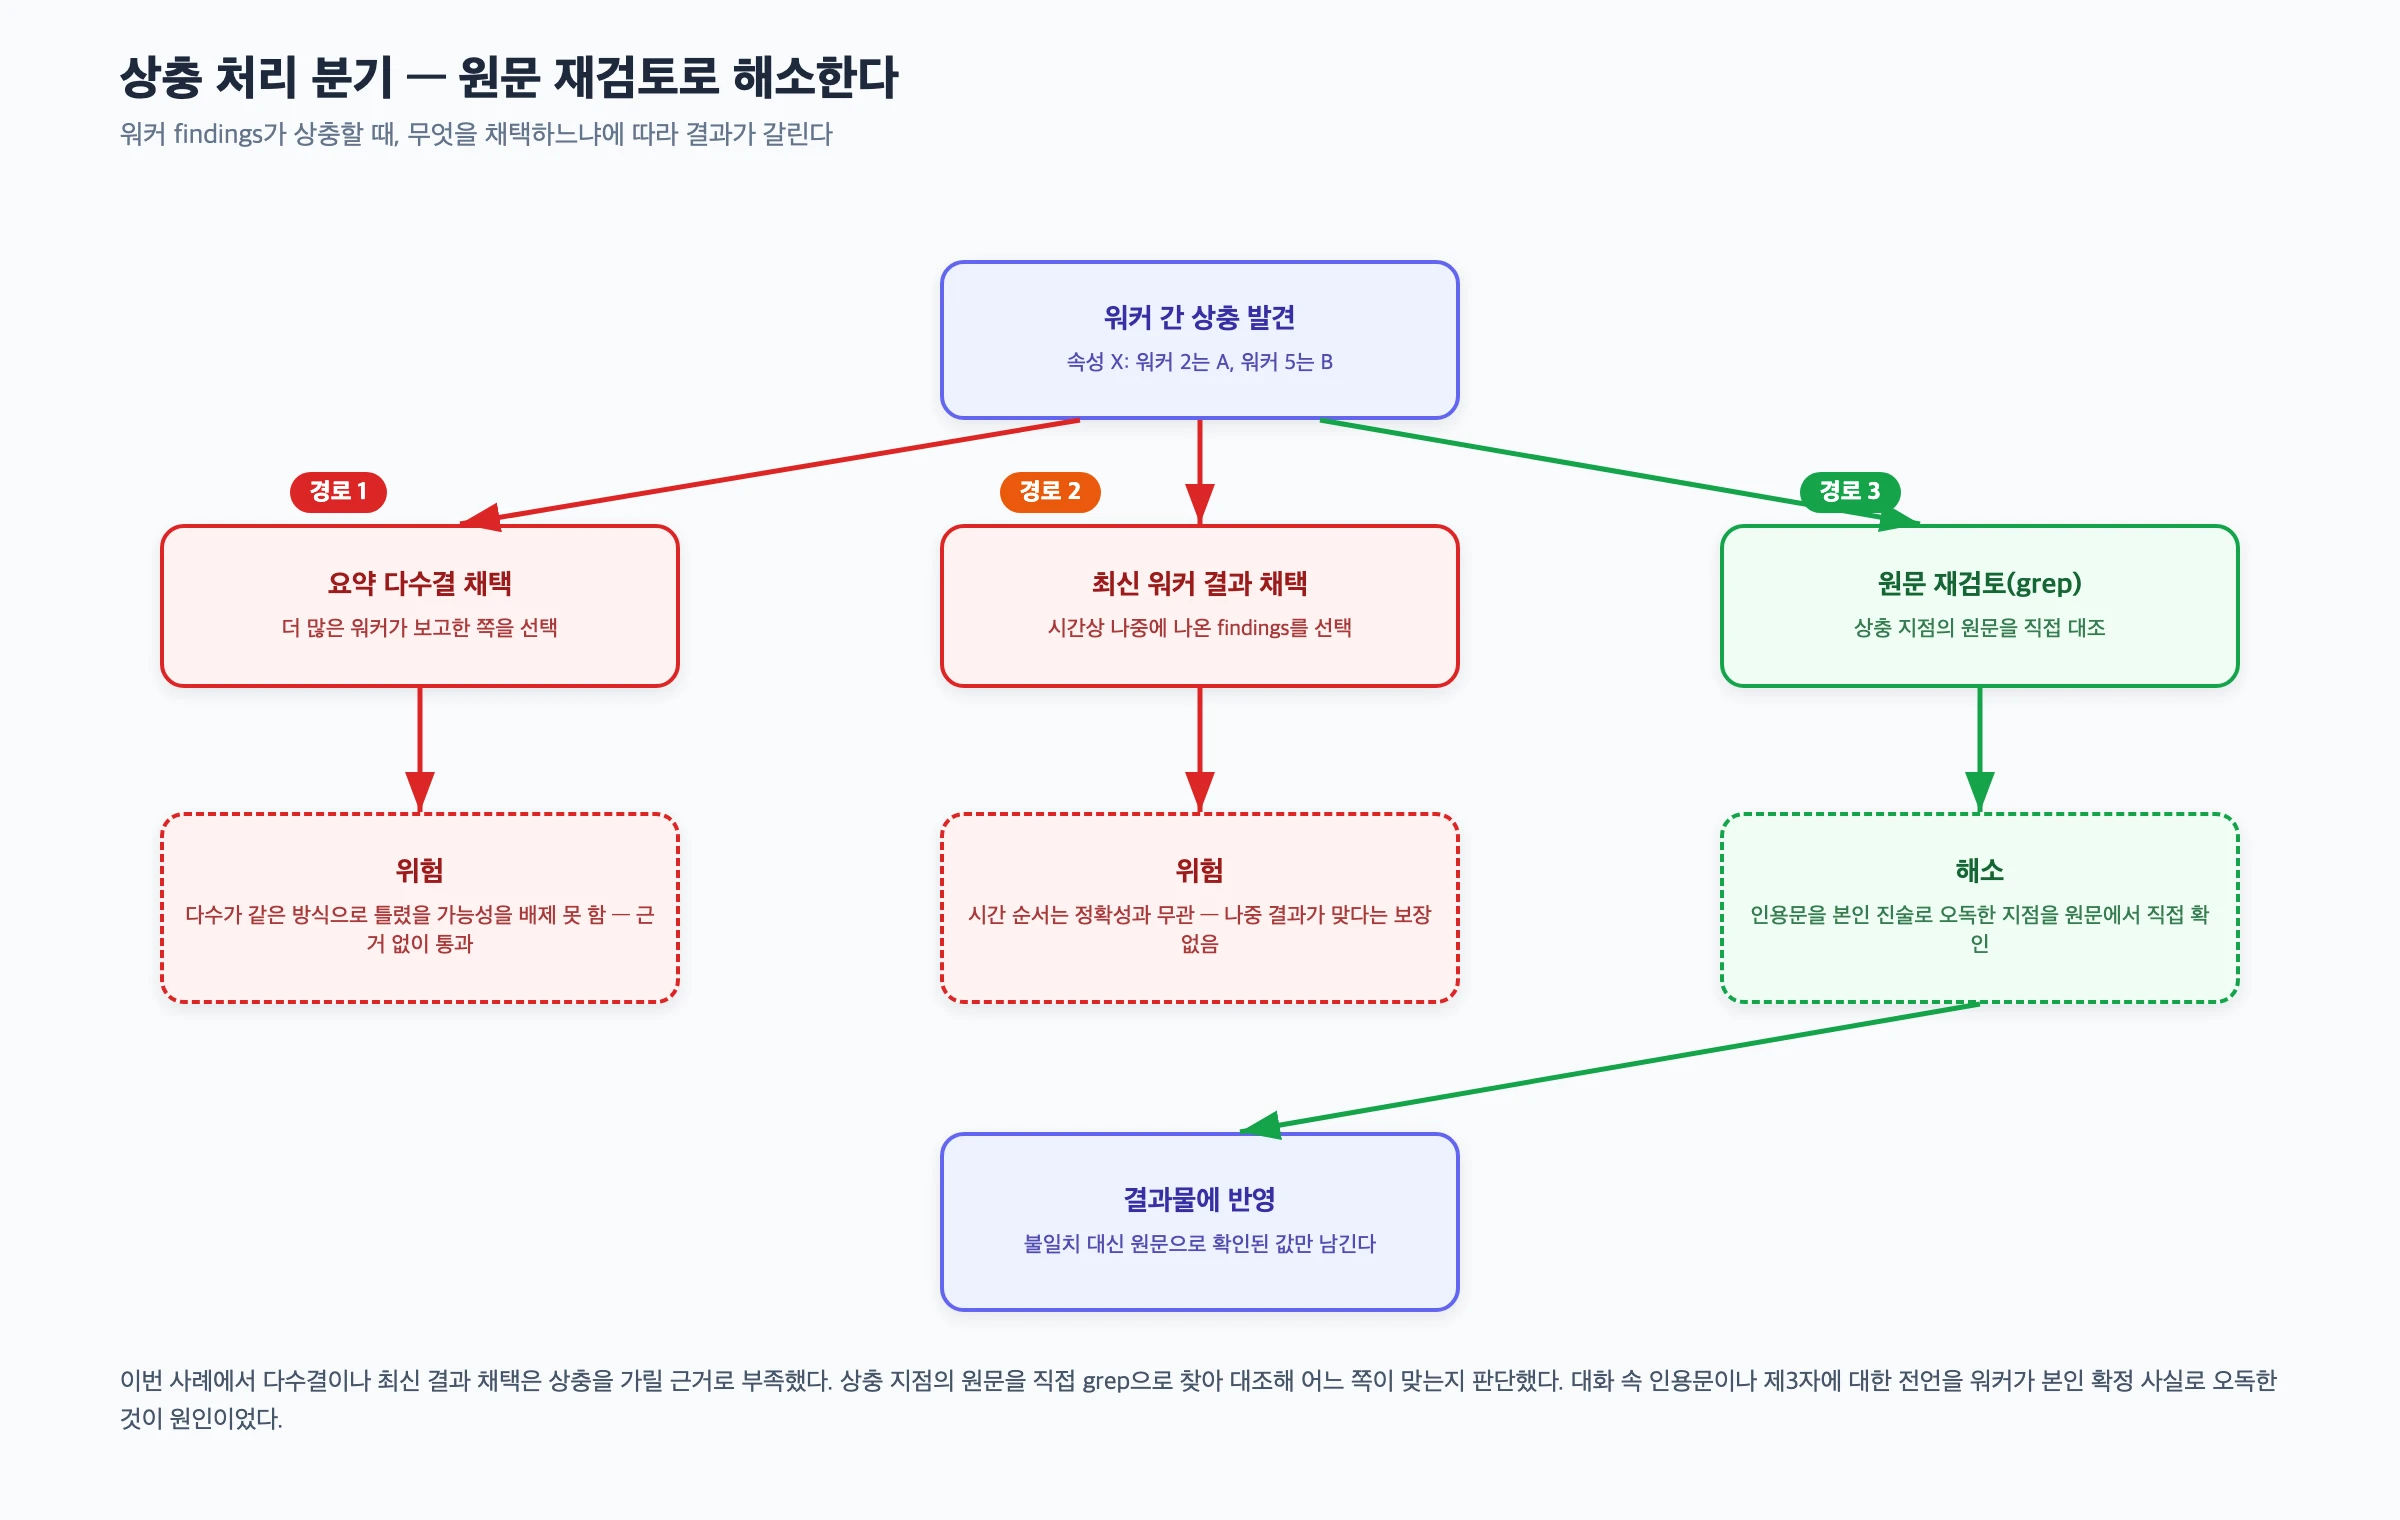
이번 오독은 인용의 화자를 판단하는 데 필요한 앞부분 맥락이 다른 구간에 있었기 때문에 생겼다. 인용문 하나가 누구의 발화인지 판단하려면 그 인용이 나오기 전의 대화 흐름이 필요했다. 해당 워커는 자기 구간만 받아 그 흐름을 볼 수 없었다. 이번 분할로 생긴 맹점은 해당 워커의 구간만으로 채울 수 없었다.
이 경험 이후로 분할 병렬 분석에 들어가기 전에 아래 항목을 먼저 점검한다. 다섯 개 중 하나라도 비어 있으면 나중에 같은 자리에서 다시 걸릴 수 있다.
| 점검 항목 | 확인할 내용 |
|---|---|
| 인코딩 복구 확인 | 원문 앞부분을 직접 눈으로 읽어 깨진 글자가 없는지 분석 전에 확인했는가 |
| 분할 축 결정 | 시간·주제·화자 중 어떤 축으로 나눌지, 그 축이 사실 일관성에 어떤 위험을 만드는지 미리 적었는가 |
| 워커 반환 형식 통일 | findings 파일 구조를 워커마다 동일하게 맞춰 나중에 나란히 대조할 수 있게 했는가 |
| 상충 해소 방법 사전 정의 | 다수결이나 최신 채택이 아니라 원문 재검토로 해소한다는 원칙을 시작 전에 정했는가 |
| 민감 정보 격리 기준 | 확정되지 않은 추정과 제3자 관련 내용을 일반 사실과 분리해 담을 폴더를 미리 정했는가 |
남은 숙제와 재사용 규칙
정리 단계에서 확정되지 않은 추정이나 제3자 관련 민감한 내용은 일반 사실과 같은 층에 두지 않았다. 별도 폴더로 격리하고 각 노트 상단에 "확정 사실 아님"을 적어 뒀다. 나중에 다시 열어 볼 때 이 한 줄이 없으면 추정과 사실이 똑같은 무게로 읽혀, 다음에 실수로 이어질 위험이 있다.
격리 기준을 정할 때 고민한 지점은 하나였다. 얼마나 확신이 없어야 격리 대상인가. 이번엔 기준을 단순하게 잡았다. 원문에서 직접 확인되지 않고 추론이나 정황으로만 뒷받침되는 내용은 전부 격리 폴더로 보냈다. 확신이 있어도 원문 인용으로 바로 보여줄 수 없으면 일단 격리부터 하고, 필요할 때 다시 꺼내 검토하는 쪽을 택했다.
이번 작업에서 적용한 규칙은 단순하다. 워커의 결론을 그 자체로 최종 사실로 채택하지 않았다. 이번 시간순 6분할에서는 처리 구간 사이의 맥락이 끊겨 워커 결론이 엇갈렸다. 발견한 상충은 원문 재검토로 해소하고, 요약만 보고 다수결이나 최신 워커 결과를 그대로 고르지 않았다. 이 절차가 전체 처리 시간에 미친 정도는 따로 측정하지 않았다.
다만 이 절차가 정확도를 보장하지는 않는다는 점도 분명히 해 둔다. 이번엔 상충을 사람이 직접 findings를 나란히 읽다가 발견했다. 워커가 낸 결과를 자동으로 대조해 상충 후보를 미리 걸러내는 절차는 아직 없다. 원문 재검토 단계를 생략했다면 이번에 발견한 오독을 놓칠 위험이 있었다. 다음에 비슷한 분량을 맡길 일이 생기면, 이 대조 단계부터 자동화하는 쪽을 먼저 시도해 보려 한다.
동시 진행과 문맥 보존 사이의 관계는 아직 측정하지 못했다. 이번 작업은 6분할 하나만 실행했으므로 구간을 더 잘게 또는 크게 나눴을 때 처리 시간과 상충 건수가 어떻게 달라지는지는 알 수 없다. 지금 쓰는 6분할이 최적값이라는 근거도 없다. 이번 작업 하나에서 택한 숫자일 뿐이라, 다음 로그 분량이 달라지면 분할 수별 처리 시간과 상충 건수부터 따로 재야 한다.
자주 묻는 질문
대용량 로그를 여러 에이전트에 나눠 맡기면 안 되나?
이번 시간순 6분할에서는 각 워커가 다른 구간만 보면서 처리 구간 사이의 맥락이 끊겼고, 같은 대상에 상충하는 결론이 나왔다. 그래서 두 결과 중 하나를 다수결이나 최신 결과로 고르지 않고 원문을 다시 대조했다. 이 사례만으로 모든 병렬 분석에서 같은 문제가 생긴다고 일반화할 수는 없다.
워커마다 결론이 다르면 어떻게 해소해야 하나?
요약만 보고 다수결이나 최신 워커 결과를 채택하지 않는다. 이번 사례에서는 상충이 발생한 지점의 원문을 직접 grep으로 찾아 두 워커의 근거를 나란히 대조해 어느 쪽이 맞는지 판단했다.
분석 전에 인코딩부터 확인해야 하는 이유는?
원문이 UTF-8인데 latin-1로 잘못 디코드되면 한글이 깨진 글자로 나온다. 이 상태로 여러 워커에 분석을 맡기면 깨진 텍스트에 근거한 결론이 나올 위험이 있으므로, 분석에 들어가기 전 원문 앞부분을 직접 확인해 인코딩부터 복구해야 한다.
이번 사례에서 워커의 오독 원인은 무엇이었나?
대화 속 인용문이나 제3자에 대한 전언을 워커가 본인 확정 사실로 오독한 경우였다. 원문 전체를 보면 인용의 화자가 누구인지 앞뒤 맥락에서 드러나지만, 자기 구간만 보는 워커에게는 그 맥락이 없었다.
아직 댓글이 없습니다.