스킬 3개를 A/B로 재 본 결과: 스킬 없는 팔이 숨은 테스트를 더 통과했다
코딩 에이전트 스킬 세 개를 스킬 없음과 있음으로 나눠 숨은 인수 테스트로 비교했다. 봉인과 예산 상한, 팔당 2회 결과와 비용, Bash heredoc 때문에 무효가 된 test_first 지표와 n=2의 한계를 정리했다.
스킬이 효과를 내기 쉬운 샘플 프로젝트를 골라 코딩 에이전트 스킬 세 개를 A/B로 시험했다. 결과는 그 기대와 반대였다. 스킬 세 개를 뺀 팔 A는 숨은 인수 테스트 46개를 두 번 모두 전부 통과했고, 스킬을 붙인 팔 B는 16개와 42개를 통과했다. 비용은 팔 B가 약 2.6배였다.
다만 한 팔에 두 번씩만 돌렸다. 이 숫자는 이 샘플 프로젝트와 이 진행 방식에서 관찰한 한 사례이고, 스킬의 일반 순위가 아니다. 이 글은 그 결과를 만든 측정 장치를 적는다. 숨은 테스트를 봉인한 방법, 예산 상한, 측정이 어긋나 무효가 된 지표 하나, 그리고 결과가 말해 주지 않는 것이다. 실험은 2026년 10월 14일에 에이전트들이 수행했다. 나는 비용을 승인했고, 이 글은 그 기록을 다시 읽고 정리한 것이다.
어떻게 비교했나: 샘플 프로젝트, 네 단계, 두 팔
시험 대상은 내 스킬 저장소에 있는 스킬 세 개였다. 아래 한 줄 설명은 역할을 요약한 것이다.
plan-grill은 구현 전에 모호한 점을 질문으로 풀게 하고, red-green-tdd는 실패하는 테스트를 먼저 쓰게 하며, session-handoff는 다음 에이전트에게 넘길 인계 문서를 쓰게 한다.
샘플 프로젝트 meterbill은 사용량 기반 API 청구서를 계산하는 작은 라이브러리다. 공개 함수는 compute_invoice(account, period, events) 하나와 예외 InvoiceError뿐이고, 파이썬 표준 라이브러리만 쓰며 결과가 결정적이다.
이 프로젝트를 고른 이유는 계획 문서에 세 가지로 적혀 있다. 숨은 규칙이 코드에서 유도할 수 없는 업무 결정이라서 plan-grill의 효과가 드러나기 쉽다. 여러 경계 조건이 있는 수직 슬라이스가 약 여덟 개라서 red-green-tdd에 맞는다. 마일스톤 2를 스테이크홀더 접근이 없는 새 에이전트에게 넘기므로 session-handoff도 쓸 일이 생긴다. 곧, 스킬이 돋보이기 쉽도록 고른 프로젝트다. 이 점은 뒤의 한계에서 다시 쓴다.
숨은 규칙은 모호성 A1부터 A10까지 열 개이고, 각각 숨은 테스트를 하나 이상 뒤집는다.
브리프는 이 규칙을 말하지 않는다. 규칙은 봉인된 스펙에만 있고, 시뮬레이션한 스테이크홀더가 QUESTION: 줄로 온 질문에 그 스펙을 보고 답한다.
이 글도 규칙의 의미는 적지 않고 id로만 부른다.
| 항목 | 팔 A | 팔 B |
|---|---|---|
| 스킬 | 없음 | 스킬 세 개의 사본을 샌드박스에 두고, 설계·구현·핸드오프 프롬프트 끝에 해당 SKILL.md를 읽고 따르라는 줄을 하나 더함 |
| 모델과 도구 | 같은 모델, 같은 노력 수준, 같은 도구 여섯 개(Bash, Read, Write, Edit, Glob, Grep), 같은 브리프와 단계 프롬프트 | |
| 반복 | 팔당 2회(A-r1, A-r2, B-r1, B-r2), 파이프라인 4개를 병렬 실행 | |
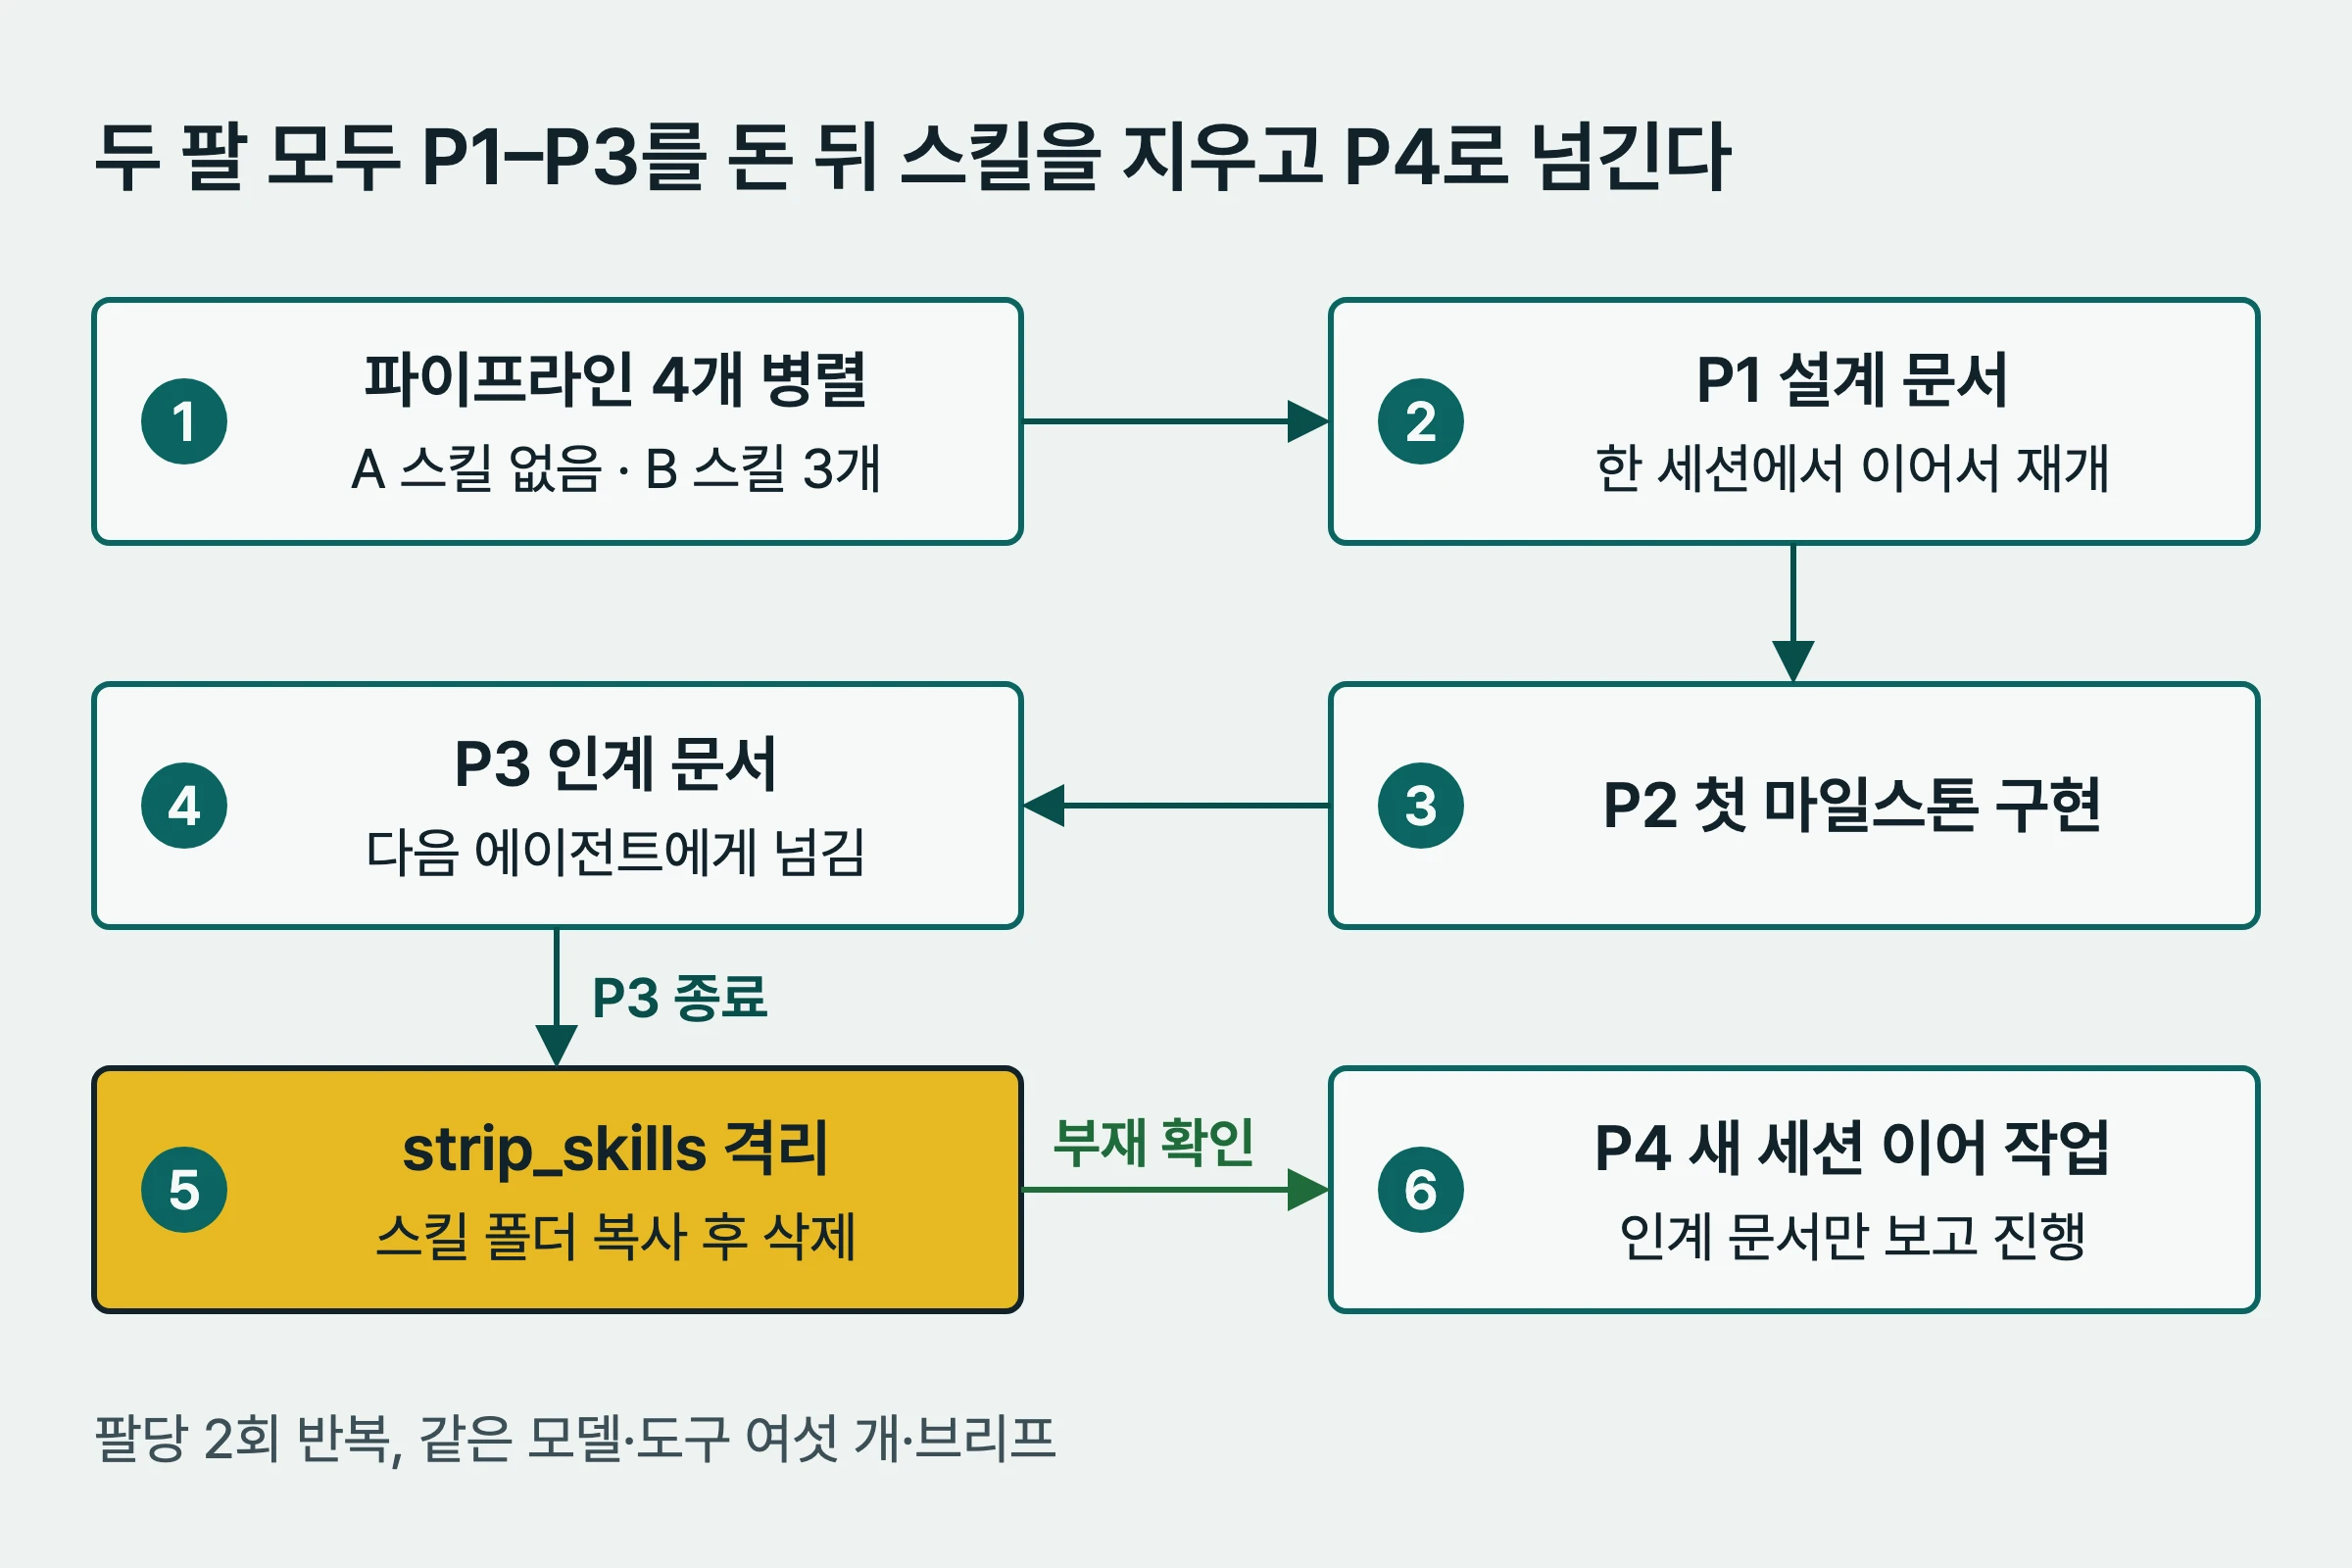
한 파이프라인은 네 단계로 돈다. P1은 설계 문서를 쓰고, P2는 첫 마일스톤을 구현하고, P3는 인계 문서를 쓴다. 이 셋은 한 세션에서 이어서 재개한다. P4는 스킬도 스테이크홀더도 없는 새 세션이 인계 문서만 보고 이어 작업한다. 아래 그림은 이 흐름과 스킬 폴더를 지우는 위치를 보여 준다.
설계 검증에서 걸린 문제가 하나 있었다.
계획 검증은 한 번 실패했고, 가장 큰 지적은 팔 B의 스킬 폴더가 샌드박스에 그대로 남는다는 것이었다. 그러면 P4의 새 세션이 스킬 파일을 Glob이나 Read로 볼 수 있어서 "P4는 두 팔 모두 스킬 없음"이라는 전제가 깨진다.
정정으로 P3가 끝나면 스킬 폴더를 실행 산출물로 복사하고 샌드박스에서 지우는 strip_skills 함수를 넣었다. P4 직전에는 두 팔 모두 스킬 폴더가 없는지 확인한다.
정정 뒤에는 재검증하지 않았다. 따라서 이 정정이 충분했는지는 검증자의 재확인이 아니라 이후의 격리 점검 결과에 기댄다.
계획에는 지표 정의의 허점도 하나 고쳤다. 테스트 실행 출력에서 FAILED ( 문자열만 세면 FAILED (errors=1) 같은 오류 실행도 센다.
그래서 의도한 단언 실패(RED)는 FAILED (와 AssertionError가 둘 다 있는 실행만 세기로 했다. 의도된 RED를 CI에서 다루는 쪽은 expected RED를 안고 가는 CI 게이트에서 따로 정리했다.
숨은 테스트를 봉인하고 예산에 상한을 둔 방법
숨은 테스트가 숨겨져 있지 않으면 비교가 의미를 잃는다.
에이전트가 자기 샌드박스 밖의 파일을 읽을 수 있다면 숨은 스펙이나 스위트를 읽고 맞출 수 있기 때문이다.
처음에는 격리를 설정 플래그로만 걸었다. claude -p에 --safe-mode, --disable-slash-commands, --setting-sources project를 주고, 실행 첫 이벤트에서 skills, slash_commands, mcp_servers가 비어 있지 않으면 하네스가 그 실행을 실패로 처리하게 했다.
이것은 에이전트가 읽을 수 있는 파일을 막지 않는다.
사고: 격리 점검이 실제 실행 네 개를 돌렸다
봉인은 이 사고 뒤에 만들었다.
하네스 로직을 구현한 뒤 격리 점검을 돌렸는데, 점검 명령에 --check-isolation 플래그를 빠뜨렸다. 점검 대신 파이프라인 네 개가 실제로 끝까지 돌았고 비용은 $6.28이었다.
저장소는 바뀌지 않았고 그 브랜치에는 숨은 스위트가 아직 없어서 숨은 테스트도 돌지 않았다. 이 실행은 지표로 쓰지 않고 시범 관찰로만 남겼다.
공교롭게도 이 실수의 비용은 뒤에 쓴 정식 실행 전체 비용($6.52)과 거의 같다.
이 사고 뒤 하네스에 드라이런 기본값과 --execute 요구를 넣었다. 돈이 나가는 하네스는 기본값이 실행이어서는 안 된다는 것은 내 해석이다.
비용 통제를 설계 문제로 보는 관점은 코딩 에이전트 비용은 하네스 설계 문제다에서 다뤘다.
이 실험에서는 같은 원칙을 다음 네 가지로 하네스에 넣었다.
- 기본은 드라이런이다. 단계별 인자만 출력하고 아무것도 실행하지 않으며,
--execute를 줘야 실제로 돈다. - 봉인된 래퍼가 아닌 바이너리는 거부한다. 거부 메시지는
refusing: --claude-bin is not the sealed wrapper이고 종료 코드는 2다. - 파이프라인마다 하드 예산 상한이 있다. 호출마다
--max-budget-usd로 남은 허용량만 넘긴다. - macOS
sandbox-exec프로필로 팔 프로세스의 읽기를 운영체제 수준에서 막는다.
막은 곳은 하네스 저장소, 작업 트리 루트, 코디네이터 실행 기록 디렉터리, 다른 Claude 프로젝트 세션, Codex 설정, 노트 볼트, 코디네이터의 임시 트랜스크립트다. 실행이 끝난 뒤에는 이 경로나 숨은 스펙의 표지가 트랜스크립트에 나오는지 스캔해서, 적중하면 그 파이프라인을 오염으로 표시한다.
다른 벤더 검토자가 찾은 봉인의 구멍 세 개
봉인 코드를 쓴 뒤 다른 벤더의 모델이 검토했고, 정확성과 안전성이 4점이어서 게이트는 실패했다. 기록된 지적은 세 건이다. 정정은 한 번만 했고 재검토는 하지 않았다. 스테이크홀더 호출에는 지출 상한이 없어서 남은 예산이 적을 때 답변 한 번이 파이프라인 상한을 넘길 수 있었다. 재시도도 갱신된 잔액을 확인하지 않았다. 잔액을 다 쓴 마지막 호출의 응답에 완료 표지(PHASE DONE)가 들어 있으면 예산 검사를 건너뛰고 complete 상태에 닿을 수 있었다. 샌드박스 프로필이 공유 작업 루트 전체를 허용해서, 스킬 폴더를 지운 뒤에도 팔 B의 남은 스킬 사본과 다른 파이프라인의 샌드박스를 읽을 수 있었다.
정정은 각각 다음과 같았다. 스테이크홀더 호출이 남은 허용량을 한도로 받고 허용량이 다하면 시도 자체를 하지 않는다. 응답 내용과 무관하게 잔액이 0 이하이면 먼저 budget으로 멈춘다. 프로필은 호출 자신의 샌드박스 하나만 허용한다.
세 번째 구멍은 설정 플래그만 봐서는 보이지 않는다. 팔이 읽을 수 있는 범위를 실제로 읽어 보는 점검이 필요했다. 이런 지적을 받은 뒤 그대로 고치지 않고 먼저 사실인지 확인하는 절차는 검증자의 지적을 그대로 고치면 안 되는 이유에 적었다.
정정 뒤 점검에서는 가짜 바이너리로 만든 예산 시나리오 세 개가 모두 상한에서 멈췄다. 매니페스트 상태는 failed: design budget이었고 이것이 의도한 멈춤이다.
실제 봉인 읽기에서는 자기 샌드박스가 읽혔다(종료 코드 0). 아래 대상은 모두 거부됐고 종료 코드는 1이었다. 자기와 다른 파이프라인의 스킬 사본, 다른 샌드박스, 숨은 스펙, 실행 기록 디렉터리, 노트 볼트, Codex 설정, 코디네이터 트랜스크립트와 스테이크홀더 비공개 파일이다.
이 검토는 재검토 없이 정정과 위 점검에 기대어 닫았다.
실행 전 점검과 실행 후 스캔
정식 실행 전에 봉인 자체 점검 10개가 모두 통과했고 두 팔 모두 격리 문제가 없었다. 임시 디렉터리를 재귀 grep으로 훑는 표지 스캔은 Codex 임시 파일 수천 개에 걸려 멈췄다. 시간 제한을 두고 범위를 한정한 find와 grep으로 바꿨다. 적중한 7건은 10월 8일부터 11일 사이의 Codex 임시 파일이었고 이 프로젝트의 고유 표지를 담은 것은 0건이었다. 반복 1이 끝난 시점의 누적 비용은 $2.95로 점검 기준 $10.50보다 낮았다. 실행 중 봉인이 거부한 경로는 git 설정, 캐시 디렉터리 생성, 상위 디렉터리 목록처럼 무해한 것뿐이었다.
실행 후 스캔의 적중은 한 건이었다. 스테이크홀더가 전달한 문장 하나가 A-r2의 인계 문서와 트랜스크립트에 나온 것이었고, 정당한 질의응답 경로다. 스위트나 스펙 사본이 나온 것은 아니다.
refusing: --claude-bin is not the sealed wrapper
failed: design budget
failed: <phase> <outcome>
위 세 줄은 하네스가 남기는 상태 문구다. 첫째는 비봉인 바이너리 거부, 둘째는 가짜 바이너리 예산 시나리오의 의도된 멈춤, 셋째는 단계가 완료를 돌려주지 못했을 때 파이프라인이 멈추는 형식이다.
결과: 스킬 없는 팔이 더 많이 통과했다
파이프라인 네 개가 모두 완료됐다. 격리 문제와 오염은 0이었고, 같은 데이터를 두 번 다시 채점한 출력은 바이트까지 같았다. 비밀 스캔에도 걸린 것이 없었다.
아래는 metrics.json의 값이다.
| 지표 | 팔 A (스킬 없음) | 팔 B (스킬 있음) |
|---|---|---|
| 최종 숨은 스위트 (46개) | 46/46, 46/46 | 16/46, 42/46 |
| P2 직후 마일스톤 1 (31개) | 31/31, 31/31 | 13/31, 28/31 |
| 첫 코드 편집 전에 정한 모호성 수 | 9, 8 (평균 8.5) | 7, 8 (평균 7.5) |
| 질문 수 | 7, 7 | 4, 6 |
| 회귀 (P2 통과 후 P4에서 실패) | 0 | 0 |
| P4의 기존 파일 수정 | 0 | 0 |
| P4 평균 비용 | $0.1602 | $0.1494 |
| 비용 합계 (두 파이프라인) | $1.80 (0.78 + 1.02) | $4.71 (2.17 + 2.54) |
팔 A는 최종 스위트 평균 46.0개, 팔 B는 29.0개를 통과했다. 비용은 팔 B가 $4.71, 팔 A가 $1.80이어서 약 2.6배다. 네 파이프라인 합계는 $6.52다. P4 단계의 평균 비용은 두 팔이 거의 같았으므로 비용 차이는 P4 이전 단계에서 생겼다. 아래 그림은 이 비교를 한 장으로 줄인 것이다.
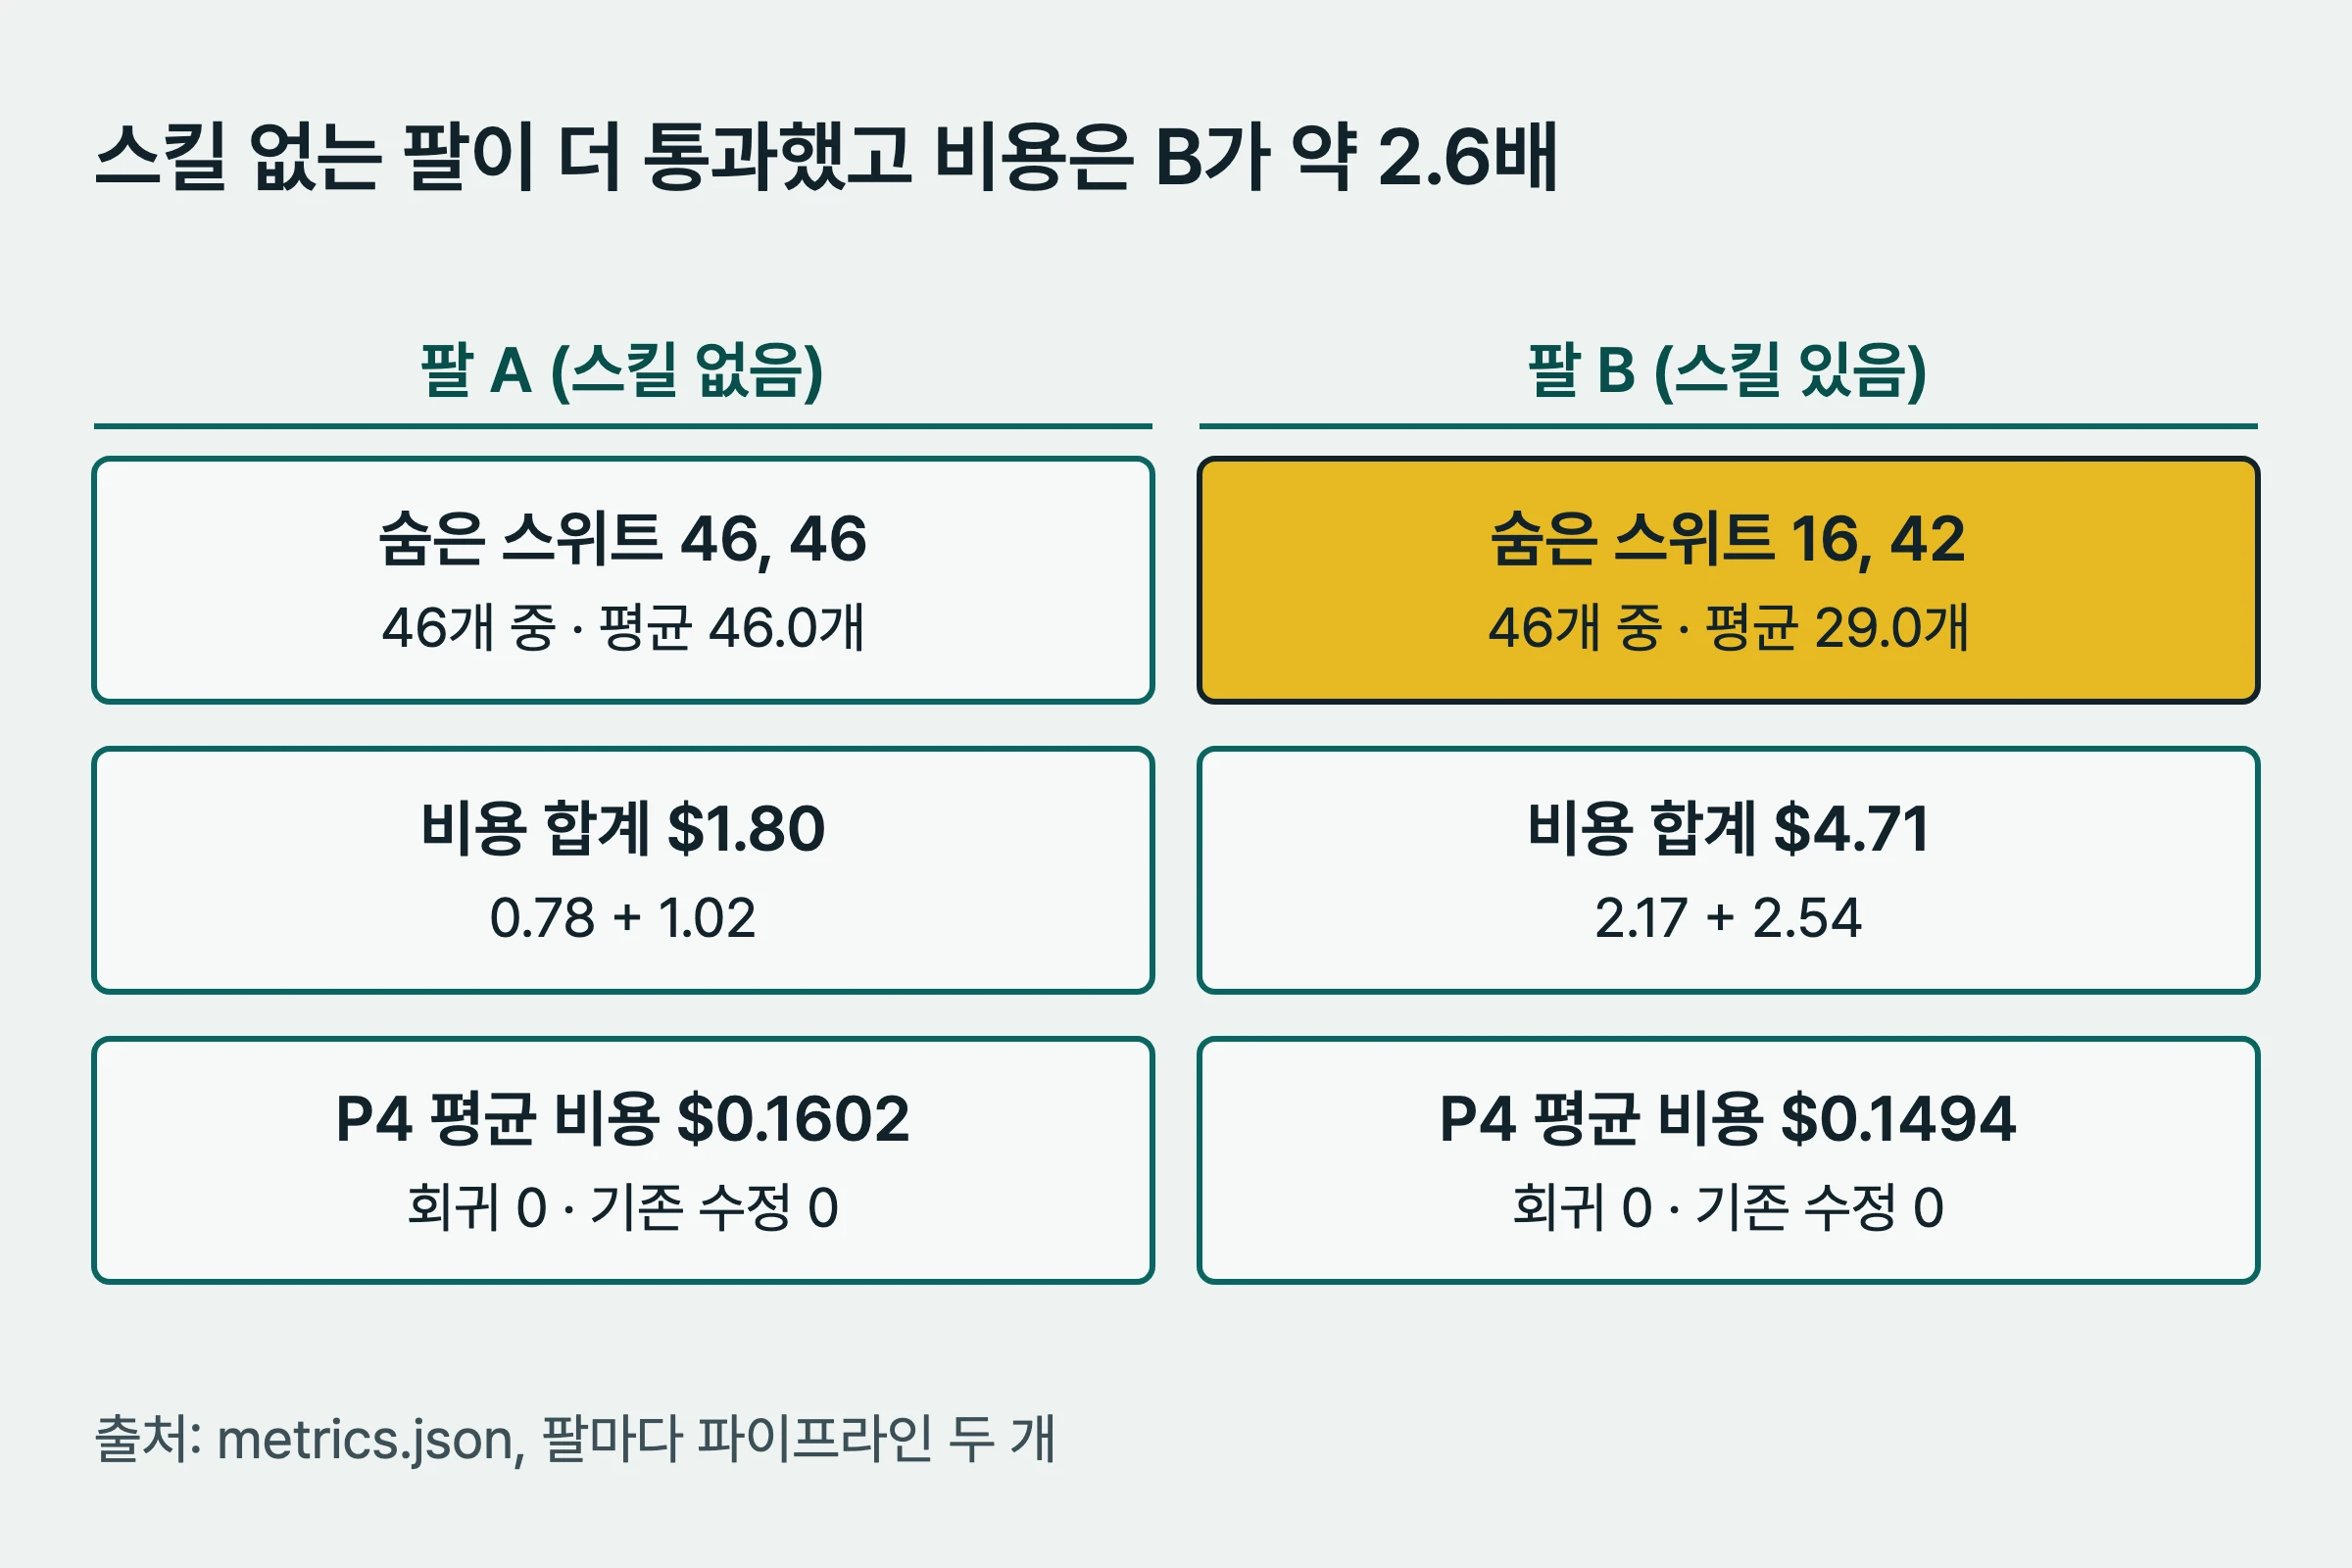
눈에 띄는 것은 팔 B 안의 차이다. B-r1은 16개, B-r2는 42개다. 두 팔 평균의 차(46.0 대 29.0, 17개)보다 팔 B의 두 실행 사이 차(26개)가 크다. 같은 설정에서 두 번 돌린 결과가 이만큼 달랐으므로, 두 팔의 차이를 스킬 탓으로 읽기에는 표본이 너무 작다는 신호다.
B-r1에는 따로 확인된 사실이 있다. 인터뷰를 일찍 끝냈고 모호성 A4를 한 번도 묻지 않았으며, A4에 해당하는 테스트가 모두 실패했다. 이것이 다른 실패로 번졌을 가능성이 있다고 본다. 이 부분은 추정이다. 기록에 남은 것은 A4 테스트 실패라는 사실뿐이고, 번졌다는 원인 경로는 확인하지 않았다.
블라인드 채점은 설계, 인계 문서, 테스트 세 항목을 봤고 두 팔이 비슷했다. 설계는 A 8.13 대 B 8.25, 인계 문서는 둘 다 8.63, 테스트는 A 8.25 대 B 7.88이다. 채점은 측정이지 합격 기준이 아니다. 채점 호출은 여섯 번이었고 달러 비용은 따로 기록하지 않았다.
스킬이 있는 팔이 숨은 테스트를 덜 통과했다는 사실과, 스킬이 숨은 테스트 통과를 떨어뜨렸다는 인과는 다른 주장이다. 이 실험에서 관찰된 것은 앞의 것뿐이다.
무효가 된 test_first와 도출 지표
red-green-tdd를 평가하려고 1차 지표 test_first를 설계했다. 소스를 고치기 전에 의도된 RED 테스트 실행이 있었는지를 Write와 Edit 도구 이벤트로 세는 지표다.
결과는 네 파이프라인 모두 0.0이었다.
이 0.0은 결과로 읽을 수 없다. 팔들이 소스를 Write나 Edit 도구가 아니라 Bash의 heredoc과 파이썬 한 줄 명령으로 고쳤기 때문이다. 지표는 그 방식을 보지 못한다. 도구 목록에 Write와 Edit가 있었는데도 에이전트가 Bash로 파일을 쓴 것이다. 0.0은 "테스트를 먼저 쓰지 않았다"가 아니라 "쓰기를 관찰하지 못했다"는 뜻이다.
그래서 보관된 트랜스크립트에서 오프라인으로 계산하는 보조 지표를 하나 더 만들었다. Bash 명령에서 쓰기를 분류해 소스 쓰기 에피소드와 테스트 실행을 세고, red 테스트 실행 뒤에 이어진 소스 쓰기 에피소드의 비율(ratio)을 낸다.
| 파이프라인 | source_write_episodes | episodes_after_red | ratio | 테스트 실행 |
|---|---|---|---|---|
| A-r1 | 1 | 0 | 0.0 | 3 |
| A-r2 | 1 | 0 | 0.0 | 6 |
| B-r1 | 11 | 7 | 0.6364 | 20 |
| B-r2 | 11 | 8 | 0.7273 | 25 |
읽는 법은 이렇다. 팔 A는 소스를 한 번의 에피소드로 썼고 그 에피소드가 red 실행 뒤에 오지 않았다. 팔 B는 약 열한 번의 작은 소스 쓰기를 했고 그중 일곱 번과 여덟 번이 red 실행 뒤에 이어졌다. 테스트 실행 횟수도 팔 A 평균 4.5회, 팔 B 평균 22.5회로 크게 달랐다. 팔 B가 작은 단위로 테스트를 오가며 일한 패턴이 관찰된다. 스킬 지시를 따른 결과인지는 확인되지 않았다. 이 방식이 숨은 통과율을 높이지는 못했다.
도출 스크립트도 검토에서 한 번 실패했다
이 도출 스크립트를 검토한 다른 벤더의 모델은 정확성 4점을 줬고 게이트는 실패했다. 지적은 셸과 파이썬을 정규식으로 짐작해 파싱한 데서 오는 결함 세 가지였다. 따옴표 안의 리다이렉션 연산자를 쓰기로 세고 공백이 있는 따옴표 대상을 잘라 먹었다. 파이썬의 쓰기 대상을 리터럴 접두어와 오래된 대입에서 짐작해 잘못 귀속할 수 있었다. heredoc 종결자를 공백을 벗긴 뒤 비교해서 들여쓴 종결자 모양의 줄이 heredoc을 일찍 끝냈다.
정정은 따옴표를 인식하는 토크나이저, ast로 파이썬 코드 파싱, 정확히 일치하는 종결자 비교(<<-일 때만 앞의 탭 제거)다. 해석할 수 없는 대상은 버리지 않고 분류 불가로 센다.
정정 뒤 반례 여덟 건이 모두 통과했고, 같은 입력의 출력이 두 번 같았다. 정정 전후의 파이프라인별 값도 같았고 분류되지 않은 쓰기는 모든 파이프라인에서 0건이었다.
독립 표본 점검도 한 번 했다. A-r1의 첫 이벤트 종류 일곱 건을 별도의 점검 스크립트로 다시 분류해 대조했더니 다섯 건이 일치하고 두 건이 달랐다. 판정 기록은 두 불일치 모두 스크립트가 맞다고 적었다. 그래도 이 지표는 트랜스크립트를 사후에 해석한 추정이다. 1차 지표를 대체하는 결론이 아니고 보완 관찰이다.
스킬별로 읽으면
아래는 세 스킬을 각각 읽은 것이다. 관찰된 것과 추정, 내 권장을 문장마다 구분했다.
plan-grill
- 관찰: 팔 B는 호출마다 질문 하나씩 물었다(질문 4개, 6개). 팔 A는 질문을 묶어서 물었다(호출 2번, 질문 7개). 이 실험의 프로토콜은 묶어 묻기를 허용했다.
- 관찰: 첫 코드 편집 전에 정한 모호성은 팔 A 평균 8.5개, 팔 B 평균 7.5개였다.
- 추정: 프로토콜이 묶어 묻기에 유리했다. 스킬이 말하는 한 번에 하나씩 묻기는 실제 사람과의 대화에서 다르게 작동할 수 있다.
- 결론: 이 프로토콜에서는 스킬이 정한 모호성 수를 늘리지 못했다.
red-green-tdd
- 관찰: 도출 지표로 보면 팔 B는 작은 소스 쓰기와 테스트 실행을 오갔고, 팔 A는 red 실행 뒤에 이어진 소스 쓰기가 없었다.
- 관찰: 이 패턴 차이가 숨은 통과율을 높이지는 못했다.
- 미확인: 패턴의 원인이 스킬이라는 증거는 없다. 팔 B의 프롬프트에 스킬을 읽으라는 줄이 있었다는 사실과 패턴 차이가 같이 나타났을 뿐이다.
session-handoff
- 관찰: 회귀 0, P4의 기존 파일 수정 0, 인계 문서 채점 평균 8.625는 두 팔이 같다. 같다고 쓸 수 있는 것은 이 세 지표뿐이다.
- 관찰: P4 이후 마일스톤 2는 팔 A가 15/15를 두 번, 팔 B가 3/15와 14/15여서 같지 않다. 보고서는 이 차이를 인계 문서의 품질로 돌리기 어렵다고 적었다. P2 직후 마일스톤 1 결과도 이미 31/31 대 13/31과 28/31로 달랐으므로, 나는 구현 상태의 차이가 이어진 것일 수 있다고 추정한다. 이 추정은 보고서에 없는 내 추정이다.
- 결론: 스킬의 효과를 분리하지 못했다.
세 스킬을 팔 B에 한꺼번에 넣은 설계에도 한계가 있다. 팔 B의 뒤 단계는 앞 단계 스킬의 영향이 쌓인 누적 관찰이라서 스킬 하나의 기여를 떼어 볼 수 없다. 이 점은 계획 검증에서 지적받아 보고서의 한계로 옮겼다.
외부 자료와 맞춰 본 것
설계가 외부 기준과 어떻게 다른지 두 자료를 직접 읽고 비교했다.
첫째는 Anthropic의 Agent Skills 개요 문서다. 문서(2026-11-04 조회, 한국어판)는 스킬이 세 단계의 점진적 공개로 로드된다고 설명한다. 시작할 때 모든 스킬의 이름과 설명만 시스템 프롬프트에 올라가고, 요청이 설명과 맞으면 SKILL.md 본문을 파일 시스템에서 읽고, 참조 파일과 스크립트는 필요할 때만 접근한다. 스킬은 관련 요청에서 자동으로 쓰인다고 적혀 있다.
이 설명과 내 팔 B는 다르다. 팔 B는 프롬프트 끝에 SKILL.md를 읽고 따르라는 줄을 직접 넣었다. 모델이 설명과 요청을 맞춰 보고 스킬을 고르는 과정이 없다. 그래서 이 실험은 스킬의 내용을 따랐을 때의 결과를 본 것이고, 스킬이 자동으로 발동하는 조건은 시험하지 못했다. 보고서도 "결과가 보여 주지 않는 것"에 자동 발동 스킬을 넣었다. 실제 사용에서 스킬이 덜 발동하거나 잘못 발동하는 경우는 이 실험 밖이다.
둘째는 SWE-bench다. SWE-bench 문서는 모델이 만든 패치를 컨테이너 환경에서 적용하고 테스트를 돌려 이슈 해결 여부를 판정한다고 설명한다. 기존에 실패하던 테스트가 통과해야 하고(FAIL_TO_PASS), 기존에 통과하던 테스트가 계속 통과해야 한다(PASS_TO_PASS). 자료는 해결책 검증에 원래 풀 리퀘스트에서 가져온, 모델에게 보이지 않는 테스트 패치를 쓴다고 설명한다. 다만 저장소의 기존 테스트가 전부 숨겨진다는 뜻은 아니다.
이 실험의 설계와 대응되는 점이 있다. 스타터 코드에서 숨은 스위트 46개가 모두 실패(의도된 RED)하고 참조 구현에서는 모두 통과하는 것을 먼저 확인했다. 회귀 지표(P2에서 통과한 테스트가 P4 뒤에도 통과하는가)는 PASS_TO_PASS와 비슷한 역할이다. 차이도 크다. 이 실험의 숨은 규칙은 실제 이슈가 아니라 이 실험을 위해 만든 가상의 청구 규칙이고, 스위트와 참조 구현도 같은 작업 흐름 안에서 작성됐다. SWE-bench를 따라 설계한 것은 아니고 읽고 나서 비교한 것이다. 보이지 않는 테스트를 두는 이유와 이 실험이 봉인에 공을 들인 이유가 같은 문제의식이라는 정도까지만 말할 수 있다.
이 실험이 말해 주지 않는 것
한계는 결론보다 앞에 둔다.
- 팔당 n=2다. 팔 B 안의 두 결과(16과 42)가 두 팔 평균의 차보다 더 벌어져 있다. 통계적으로 뒷받침된 순위가 아니다.
- 스킬이 일반적으로 효과가 없다는 증거가 아니다. 프로젝트 하나, 모델 하나, 프로토콜 하나다.
- plan-grill은 실제로 한 번에 하나씩 묻는 인터뷰에서 시험하지 못했고, 스킬의 자동 발동도 시험하지 못했다.
- 팔 B 실패의 정확한 원인은 모른다. B-r1의 A4 누락은 단서일 뿐이다.
- test-first의 엄격한 증거가 없다. 1차 지표는 무효고 보조 지표는 사후 추정이다.
- 프로젝트를 스킬이 돋보이기 쉬운 쪽으로 골랐고, 숨은 규칙과 스위트도 스킬과 같은 하네스 저장소 안에서 만들었다. 이 선택이 결과에 준 영향은 모른다.
- 원래 결과 보고서는 모델 검토를 한 번도 통과하지 못했다. 두 번 실패했고(관찰을 넘는 인과 주장, 마일스톤 2 결과의 과장 등), 작성자가 정정했으며 숫자 249개를 지표 파일과 대조해 불일치 0건을 확인한 뒤 수용했다. 이 글은 그 보고서와 원기록을 다시 읽어 쓴 것이고, 독립 검토를 거치기 전의 글이다.
다음 실험에서 바꿀 점은 아직 하지 않은 권장이다. 팔당 반복 수를 늘리고, 질문 방식을 두 팔 모두 한 번에 하나로 고정한 변형을 따로 돌리고, 스킬을 하나씩 넣는 팔을 만든다. 쓰기 지표는 도구 이벤트가 아니라 파일 시스템 변화를 도구와 무관하게 기록하도록 바꾸는 것을 권한다. 이번에 무효가 된 지표 하나가 그 이유다.
비슷한 하네스 사고 기록은 멀티에이전트 코딩에서 실제로 사고 난 것들과 프로그래밍 카테고리에 모아 둔다.
자주 묻는 질문
그래서 스킬을 쓰지 않는 편이 낫다는 뜻인가?
그렇게 읽으면 안 된다. 팔당 두 번씩 돌린 한 프로젝트의 관찰이고, 팔 B 안의 두 결과(16/46과 42/46)가 크게 달랐다. 이 실험이 보인 것은 이 프로토콜에서 스킬을 붙인 팔이 숨은 테스트를 덜 통과했고 비용이 약 2.6배였다는 점까지다.
숨은 테스트는 어떻게 숨겼나?
macOS의 sandbox-exec 프로필로 팔 프로세스가 숨은 스펙과 스위트를 읽지 못하게 막았다.
실행 뒤에는 트랜스크립트에서 숨은 스펙의 표지를 스캔해 오염 여부를 확인했고, 네 파이프라인 모두 오염은 0이었다.
test_first 지표는 왜 무효가 됐나?
그 지표는 Write와 Edit 도구 이벤트만 봤는데, 에이전트들이 Bash의 heredoc과 파이썬 한 줄 명령으로 소스를 고쳤기 때문이다. 그래서 0.0은 테스트를 먼저 쓰지 않았다는 뜻이 아니라 쓰기를 관찰하지 못했다는 뜻이다. 대신 트랜스크립트에서 Bash 쓰기를 분류하는 보조 지표를 만들었다.
같은 실험을 다시 하려면 무엇을 바꿔야 하나?
반복 수를 늘리고, 스킬을 하나씩 넣는 팔을 만들고, 쓰기 지표를 도구와 무관하게 기록하도록 바꾸는 것을 권한다. 이 세 가지는 아직 실행하지 않은 권장이다.
출처
- Agent Skills 개요 - Claude Platform Docs (2026-11-04 조회): 스킬의 점진적 공개와 자동 사용에 관한 설명.
- SWE-bench (2026-11-04 조회): FAIL_TO_PASS와 PASS_TO_PASS 테스트로 모델 패치를 판정하는 방식.
- 실험 수치는 2026년 10월 14일 실행의 작업 기록(계획, 봉인, 실행, 도출, 보고서 단계)에서 가져왔다. 숨은 규칙의 의미와 트랜스크립트 내용은 공개하지 않는다.
아직 댓글이 없습니다.