리뷰 봇 판정이 사람 계정과 Nit 문구에 속은 이유: Bot 타입 확인과 빨간 표식만 차단하도록 고친 기록
사람 계정과 Nit 문구를 잘못 차단하던 리뷰 봇 판정을 타입과 빨간 표식 기준으로 고친 기록이다. 시험을 먼저 실패시킨 과정과 합성 댓글 시험, 실제 봇 댓글을 관찰하지 못한 한계도 살펴본다.
리뷰 봇 판정 함수가 사람 계정과 Nit 문구 속 단어에 속아 병합을 막는 지적을 잘못 골랐다. 에이전트가 작성자 타입을 확인하고 Claude 봇은 빨간 원 표식으로 차단하도록 고쳤다. 나는 이 글에서 그 판정과 시험 과정을 다룬다. 모델 선택이나 승격 흐름 전체는 범위에 넣지 않는다.
내 하네스 저장소에서는 병합 전에 scripts/post-verified.py가 harness/verified 커밋 상태를 게시한다. 차단 대상 리뷰에 처리 기록이 없으면 성공 상태를 게시하지 않는다. 처리 기록은 수정, 사유를 적은 답변, 이슈 가운데 하나다. 그래서 리뷰가 차단 대상인지 잘못 판단하면 상태 게시도 잘못 막힐 수 있다.
이 글의 변경과 당시 시험은 에이전트들이 수행했다. 나는 글을 준비하면서 2026년 11월 11일에 저장소를 읽기 전용으로 사용해 판정을 다시 계산하고 현재 시험 파일을 한 번 실행했다. 당시 실행 기록과 오늘의 결과는 서로 다른 증거이므로 따로 적는다.
사람과 Nit를 차단한 판정
중심이 된 실행은 2026년 10월 27일에 진행됐다. 해결 대상으로 기록된 결함은 두 가지였다. 이름이 claude로 시작하는 사람 계정도 봇으로 취급했고, 봇이 남긴 Nit 문구에 Important라는 단어가 들어가도 차단했다. 두 결함은 이 실행에서 이슈로 처리되어 닫혔다. 이슈가 처음 올라온 시점은 기록에 없어 특정하지 않는다.
그보다 앞선 같은 세션의 첫 실행에서 에이전트는 Claude GitHub 봇의 Important 등급을 병합 전 외부 증거로 다루는 규칙을 스크립트와 문서에 넣었다. 규칙은 봇의 P1/P2 지적을 처리하고 기록하도록 했다. Claude 봇에는 Important 등급이 대상이었다. 봇 요약은 독립 리뷰나 시험을 대신하지 않으며, 봇이 게시하지 않아도 기다리지 않는다는 조건도 있었다. 시험 PR과 로직 PR이 병합된 사실은 PR 조회로 확인됐다.
첫 실행의 로직 리뷰에서는 이미 로그인 판정에 관한 지적이 나왔다. 리뷰어는 요구된 claude[bot]과 달리 claude-로 시작하는 로그인도 허용한다며 coverage에 6점을 줬다. 근거는 스크립트의 25행과 41행으로 제시됐다. 같은 시도에서 점수 게이트는 score-gate.py 37행의 리뷰 scores 키 집합 단언에서 AssertionError를 내고 종료 코드 1로 끝났다.
나는 그 첫 실행의 최종 게이트 통과 기록을 실행 디렉터리에서 찾지 못했다. 따라서 병합이 확인된 사실과 최종 게이트 증거를 찾지 못한 사실을 나란히 둔다. 뒤에 고친 로그인 결함은 앞선 리뷰 지적과 방향이 같다. 다만 기록에 없는 이슈 생성 시점이나 그 사이의 사건을 추정하지는 않는다.
당시 판정과 수정된 판정에서 관련 부분은 다음과 같다. 줄을 짧게 나누었으며, 비교 대상은 기록에 제시된 정규식과 함수다.
CLAUDE_BOT = re.compile(r"^claude[-\w]*(\[bot\])?$", re.IGNORECASE)
CLAUDE_BLOCKING = re.compile(r"\U0001F534|\bImportant\b")
CLAUDE_BOT.match(login) is not None and \
    CLAUDE_BLOCKING.search(body) is not None

CLAUDE_BOT = re.compile(r"^claude(-code)?\[bot\]$", re.IGNORECASE)
CLAUDE_BLOCKING = re.compile(r"\U0001F534")

def is_review_bot(comment):
    user = comment.get("user") or {}
    if user.get("type") != "Bot":
        return False
    login = user.get("login", "")
    return login == "chatgpt-codex-connector[bot]" or \
        CLAUDE_BOT.match(login) is not None

def is_blocking(comment):
    if not is_review_bot(comment):
        return False
    user = comment.get("user") or {}
    body = comment.get("body") or ""
    if user.get("login") == "chatgpt-codex-connector[bot]":
        return re.search(r"\bP[12]\b", body) is not None
    return CLAUDE_BLOCKING.search(body) is not None
옛 로그인 정규식에서는 접미사 [bot]이 선택 사항이었다. 중간의 [-\w]*도 이름 뒤의 문자를 허용했다. 그래서 claude, claude-reviewer, claude[bot]이 모두 맞았다. 이 판정은 댓글 작성자의 user.type을 보지 않았다. 본문에서는 빨간 원이나 단어 Important 중 어느 하나만 발견해도 차단 대상으로 셌다.
새 판에서는 먼저 작성자 타입이 Bot인지 확인한다. 그다음 Codex 커넥터 로그인 또는 정해진 Claude 봇 로그인인지 본다. Claude 로그인은 대소문자를 구분하지 않고 claude[bot]과 claude-code[bot] 형태를 허용한다. Codex 커넥터는 계속 본문의 P1/P2를 기준으로 삼는다. Claude 봇에는 빨간 원 표식만 남겼다.
두 함수의 문서 문자열에는 순수 함수라고 적혀 있다. 댓글 입력으로 판정값을 돌려주기 때문에 봇 식별과 차단 여부를 각각 살필 수 있다. 처리 기록이 없는 차단 항목에 성공 상태를 거부하는 동작은 그 판정에 이어지는 별도의 조건이다. 봇처럼 보이는 이름과 실제로 차단할 본문을 나눠 살피는 것이 이 수정에서 확인할 지점이다.
차단 여부는 작성자와 지적의 표식을 함께 본 결과다. 이름의 접두사나 본문 속 단어 하나만으로는 이 실행에서 원한 대상을 구분하지 못했다.
다섯 입력으로 비교한 결과
나는 오늘 순수 파이썬 re로 옛 정규식과 새 정규식, 타입 검사를 같은 입력에 적용했다. 아래 값은 그 재측정 결과다. True는 병합을 막는 지적으로 셌다는 뜻이고, False는 이 판정에서 차단 대상으로 세지 않았다는 뜻이다. 실제 GitHub에서 댓글을 가져온 결과는 아니다.
| 로그인 | user.type | 본문 | 옛 판정 | 새 판정 |
|---|---|---|---|---|
| claude-reviewer | User | 🔴 Important: wrong branch | True | False |
| claude[bot] | Bot | 🟡 Nit: the word Important appears here | True | False |
| claude[bot] | Bot | 🔴 bug: wrong branch | True | True |
| claude[bot] | Bot | 🟡 Nit: rename variable | False | False |
| some-human | User | 🔴 Important: wrong branch | False | False |
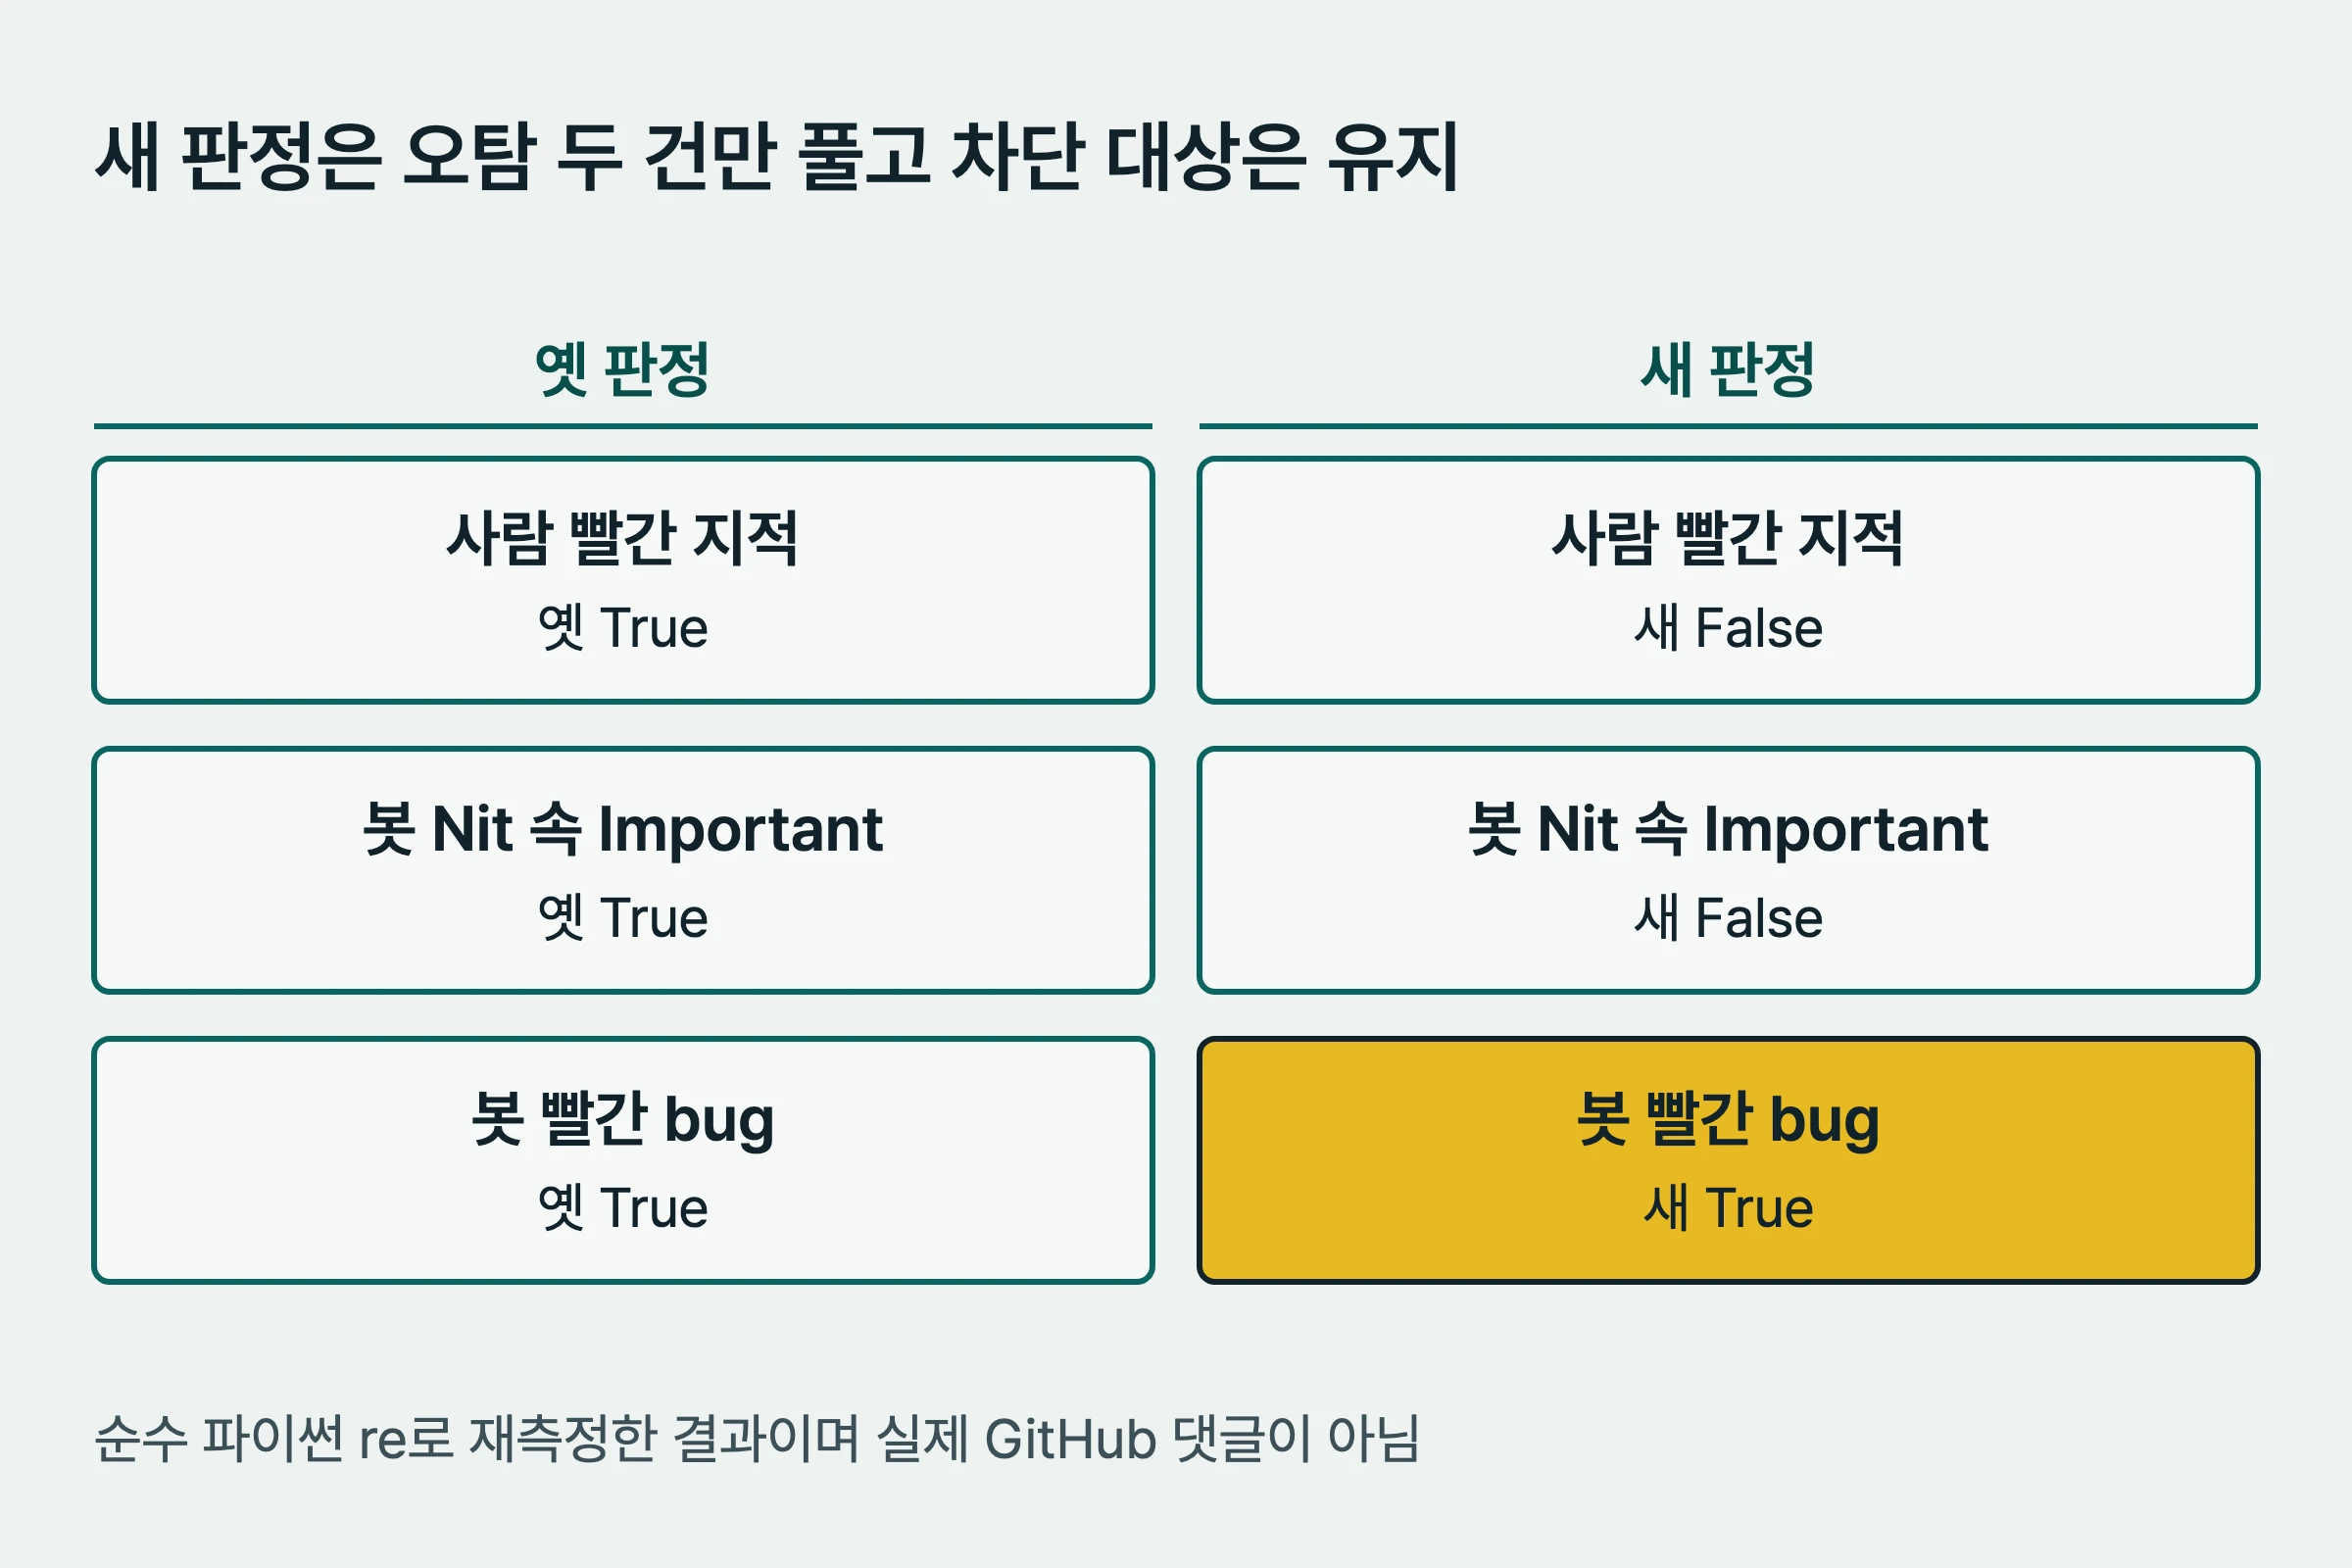
첫 행은 사람이 남긴 빨간 지적이다. 옛 판은 로그인 접두사와 본문 표식이 모두 조건에 맞아 True를 냈다. 새 판은 작성자 타입이 User이므로 봇으로 분류하지 않았다. 해당 댓글이 실제로 중요했는지에 대한 판단이 아니라, 이 스크립트가 정한 봇 리뷰 차단 대상인지에 관한 결과다.
둘째 행의 작성자는 시험 입력상 봇이지만 본문은 노란 Nit다. 옛 판은 문장 안의 Important를 찾아 차단했다. 새 판은 빨간 원이 없어서 차단하지 않았다. 두 행에서 바뀐 값은 각각 사람을 봇으로 센 오탐과 Nit의 단어를 등급으로 센 오탐을 보여 준다.
셋째 행은 차단이 필요한 입력을 계속 차단하는지 확인하는 사례다. 봇 타입과 허용된 로그인이 있고 본문에도 빨간 원이 있어 양쪽 결과가 True다. 반대로 넷째 행은 단어도 빨간 원도 없는 Nit다. 이전과 이후 모두 차단하지 않으므로 변경 전부터 허용되던 대조군이다.
다섯째 행도 대조군이다. 빨간 원과 단어가 있어도 로그인 이름이 claude로 시작하지 않으면 옛 판정도 무시했다. 첫 행과 나란히 보면 사람이라는 사실만으로 옛 코드가 모든 사람을 차단한 것은 아니다. 첫 행의 잘못된 결과에는 로그인 접두사 매칭이 작용했다는 점을 분리해서 볼 수 있다.
표는 제한된 입력에 대한 판정 결과다. 성공 상태가 실제로 게시됐는지까지 이 표에서 알 수는 없다. 그 동작은 처리 기록의 유무와 함께 시험한 기록으로 살펴봐야 한다. 판정 함수의 결과와 그 결과를 사용하는 상태 게시 절차를 같은 증거로 뭉뚱그리지 않는 편이 정확하다.
실패하는 시험부터 병합까지
에이전트가 남긴 설계 노트는 필요한 능력을 네 가지로 나눴다. 이 구분은 로그인 확인만 고치고 기존의 다른 차단 조건을 놓치지 않기 위한 작업 범위를 보여 준다.
- C1: 리뷰 작성자가 대상 봇인지 판정한다.
- C2: Claude 봇의 차단 기준을 빨간 원 표식으로 제한한다.
- C3: Codex의 P1/P2 차단은 유지한다.
- C4: 차단 항목에 처리 기록이 없으면 성공 응답을 거부한다.
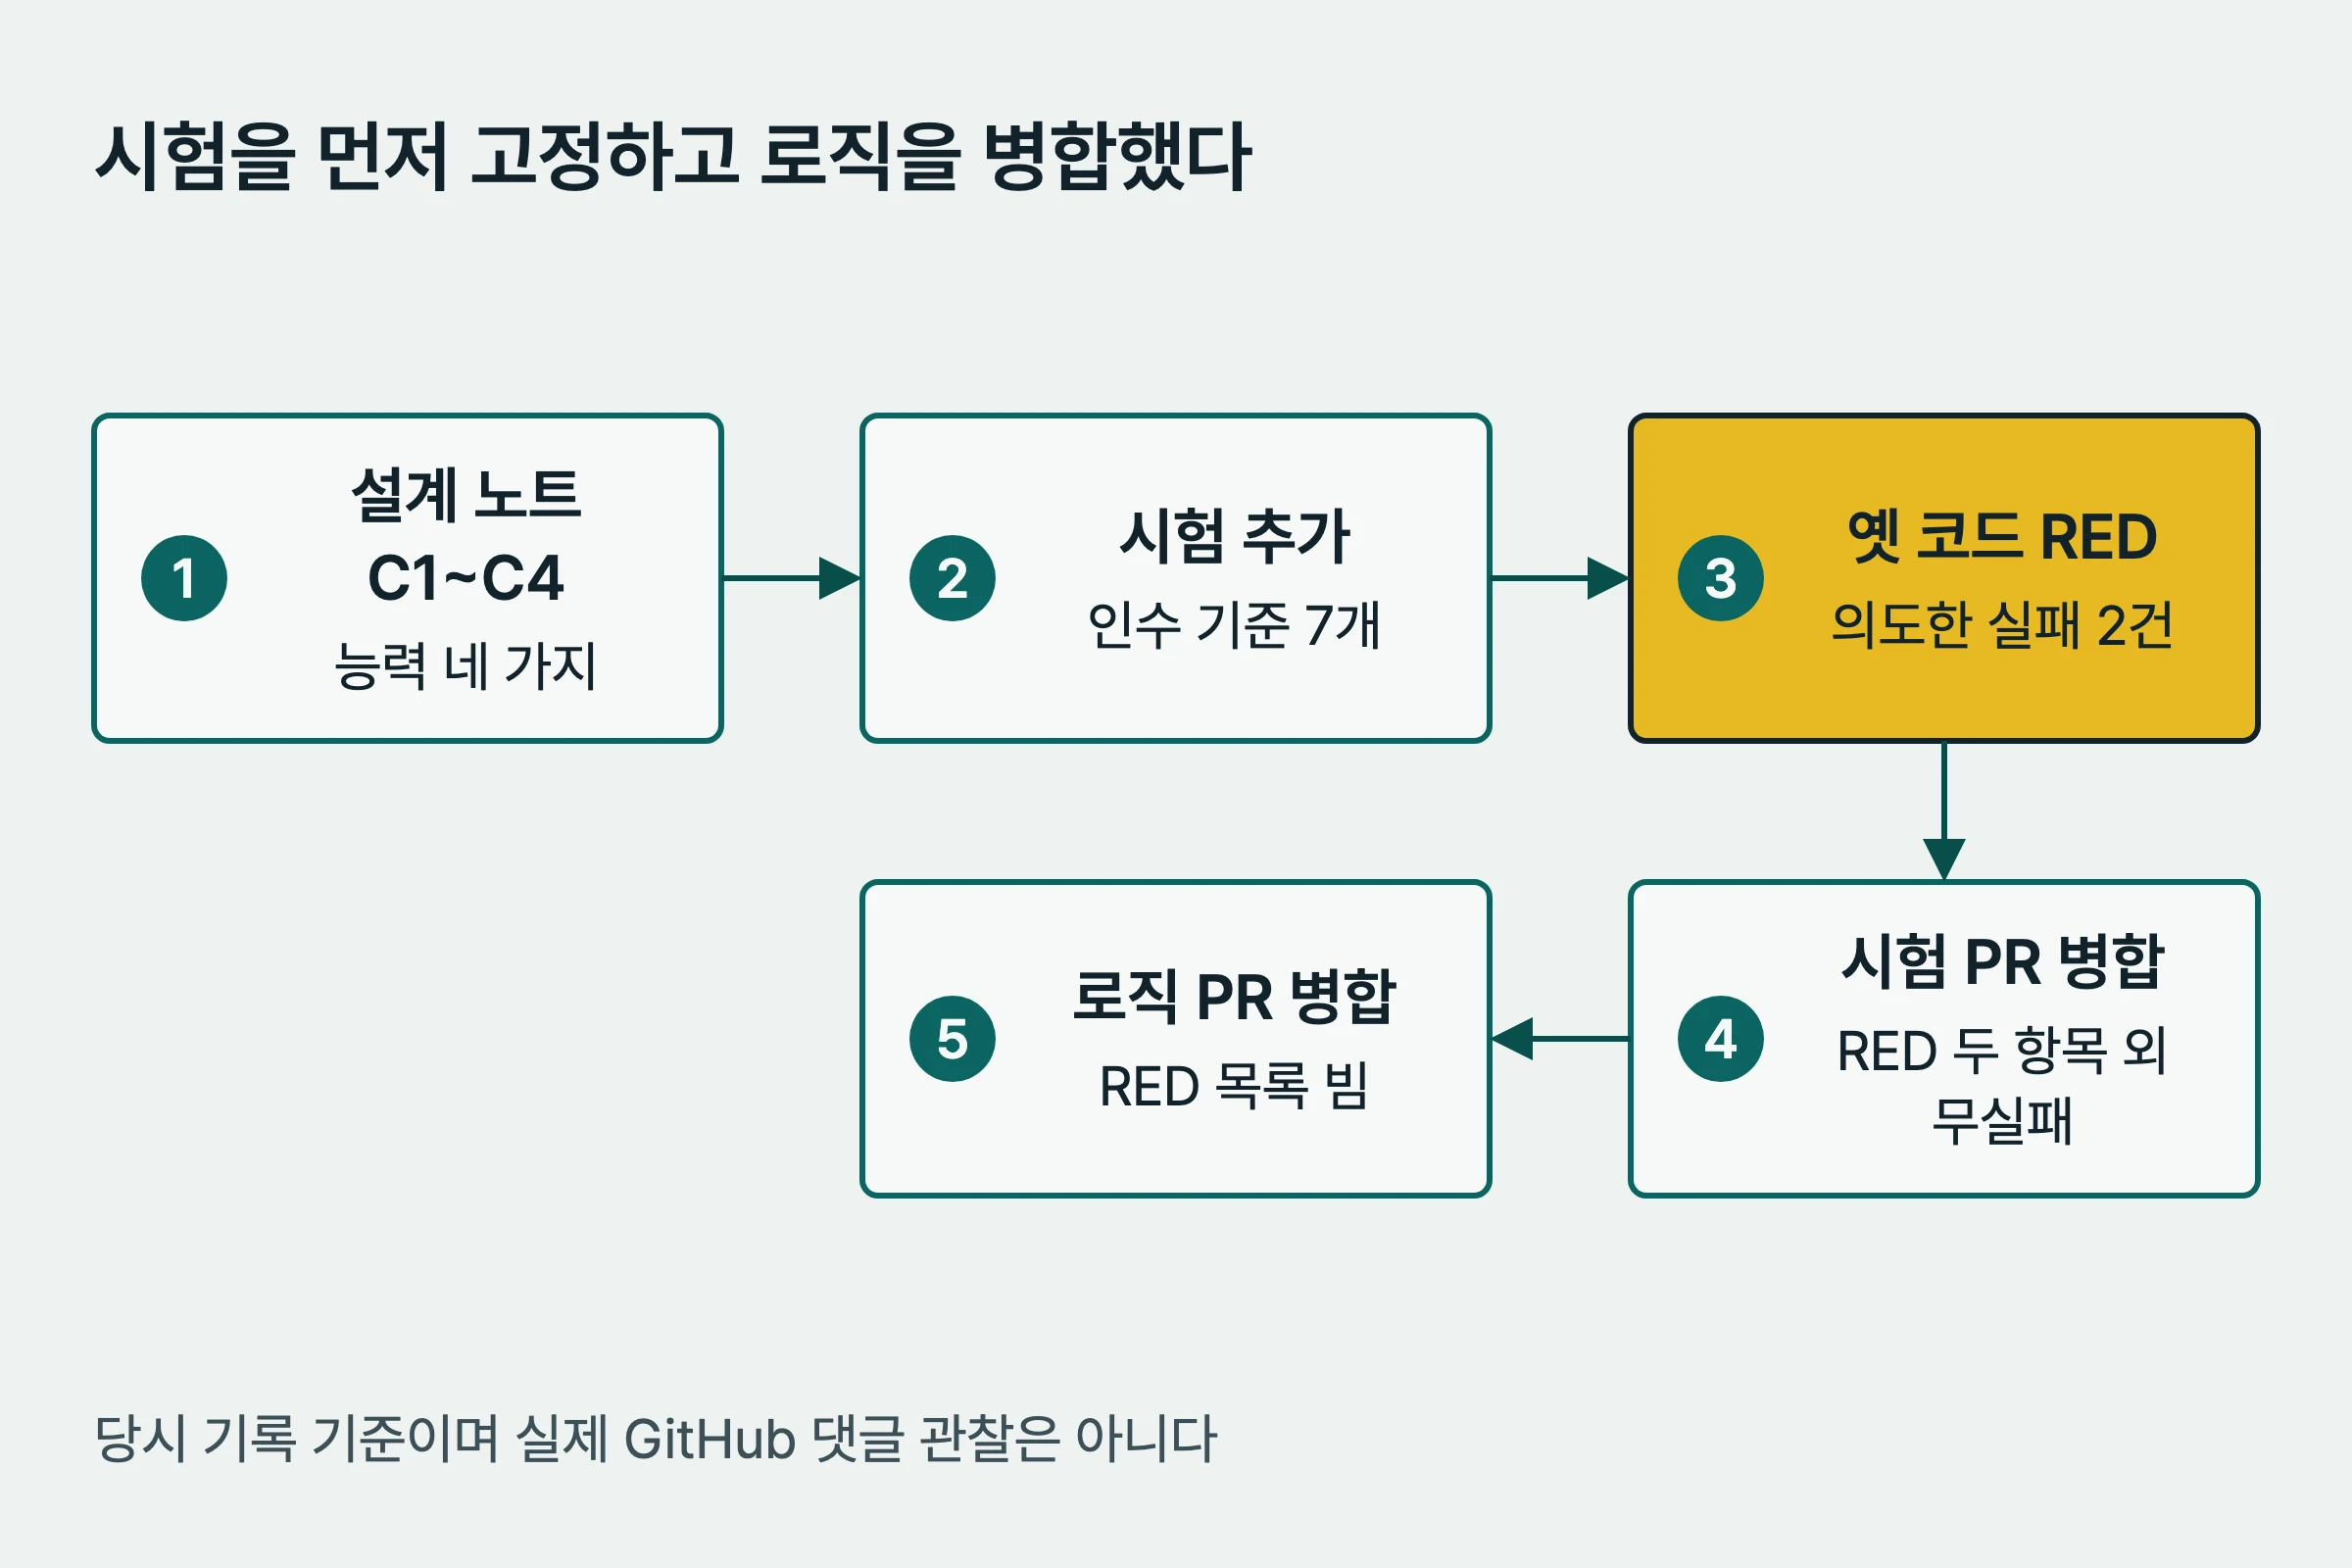
시험 노드에는 인수 기준 7개가 있었다. 에이전트는 먼저 사람 claude-reviewer의 빨간 지적을 무시해야 한다는 시험을 추가했다. 또 claude[bot]의 Nit 본문에 Important가 있어도 무시해야 한다는 시험을 추가했다. 옛 코드에서는 두 요구가 받아들여지지 않아 의도한 대로 실패했다. 이 두 실패가 수정 전 기준선의 의도된 RED였다.
시험 PR은 의도된 RED 두 항목을 제외한 실패가 없는 상태에서 먼저 병합됐다. 그다음 로직 PR이 병합됐다. 수정 뒤 의도된 RED 목록은 비었다. 이 순서는 새로운 기대를 먼저 시험으로 고정하고 기존 구현이 그 기대와 어긋나는지 확인한 기록이다. 시험이 먼저 들어갔다는 사실만으로 실제 서비스에서 봇 댓글을 관찰했다는 뜻은 아니다.
수정된 시험 파일은 로그인 변형도 다룬다. claude-code[bot]과 대소문자가 다른 Claude[bot]의 Important 지적에는 처리 기록이 없으면 성공을 거부한다. 반면 Nit와 보라 표식의 Pre-existing 지적은 기록 없이 허용한다. 사람 계정의 빨간 지적과 Nit 안에 들어간 단어도 앞서 설명한 대로 무시한다. 무관한 사람의 Important 지적 역시 대상에서 뺀다.
이 시험은 실제 GitHub에 댓글을 올려 확인한 것이 아니다. 가짜 gh 상태 디렉터리에 댓글 JSON을 만들고 user.login, user.type, body를 입력한다. 따라서 주어진 JSON을 스크립트가 어떻게 처리하는지는 살필 수 있다. GitHub 앱이 실제로 어떤 댓글을 게시하는지까지 이 시험으로 확인할 수는 없다.
병합된 수정의 기록에는 스크립트와 문서 두 개, 기대 RED 목록, 시험 파일까지 모두 5개 파일이 나온다. 같은 수정에서 시험 파일은 12줄이 빠졌다. 제거된 항목에는 AC5의 목록 단언이 있었다. 그 단언은 로직 변경 전 목록을 기대했으므로 수정과 함께 제거됐다고 커밋 메시지에 적혀 있다.
이 실행의 검증 기록에는 pyright 오류 0과 tests/*.test.sh 60개 통과가 남아 있다. 호스트의 python3 심볼릭 링크를 바꿔 파이썬 3.15와 tomllib 환경에서 전체 스위트 60/60 통과도 확인했다. 이는 당시 기록의 결과다. 오늘 내가 다시 돌린 시험 파일의 결과와 동일한 실행으로 취급하지 않는다.
오늘 현재 tests/post-verified.test.sh를 한 번 실행한 결과는 64개 중 61개 통과, 3개 실패였다. 봇 판정 쪽 시험은 모두 통과했지만 이 파일 전체로는 3개가 실패했다. 실패한 이름은 모두 cutover …로 시작했고 리뷰 문서 전환 기능과 관련된다. 해당 시험들은 2026년 11월 9일의 시험 커밋에서 추가됐다. 봇 판정과 무관한 영역이며 실패 원인은 조사하지 않았다.
오늘 출력에는 사람 접두사 계정의 빨간 지적을 무시한 항목과 Nit의 단어를 무시한 항목이 통과로 나타났다. 두 로그인 변형에서 처리 기록 없는 Important 지적을 거부한 항목도 통과했다. 무관한 사람의 지적을 무시한 항목도 마찬가지다. 실행 시간은 time 출력에서 14.132 total로 표시됐다. 이 결과는 해당 파일의 실패 세 건을 지우지 않는다.
실행 기록과 남은 한계
당시 시험 PR의 상태 게시에는 기록된 예외가 있었다. 의도된 RED가 있으므로 시험 스위트 종료 코드 1은 예상된 상태였다. 그런데 post-verified.py의 test-class 정정 경로는 종료 코드 0을 요구했다. 조정자는 이 실행에서 스크립트 대신 gh api로 시험 PR의 harness/verified 상태를 직접 게시했다. 기록된 단일 예외다.
이 가드 결함은 이슈로 올라 닫혔다. 세션 기록에는 다른 실행에서 고쳐졌다는 말이 있지만, 나는 이 실행의 산출물에서 그 연결을 직접 확인하지 못했다. 수동 게시가 있었다는 사실과 이후 수정의 연결을 확인했다는 주장은 구분해야 한다. 시험 PR이 병합됐다는 결과만으로 스크립트의 정정 경로가 당시 정상 작동했다고 결론 낼 수 없다.
로직 리뷰의 통합 검토 5번은 잘못된 증거에서 나온 실패로 기록됐다. 정정된 증거로 다시 확인했지만 재검토는 하지 않았다. 로직 작성자는 커밋 메시지를 다시 쓰며 자기 브랜치를 한 번 force-push했다. 검토되지 않은 브랜치가 바뀐 기록이다. 원시 작성자 JSON 해시는 저장되지 않았다. 또 이 실행의 노트에서는 Codex 커넥터와 Claude 봇 요약의 인라인 발견을 확인하지 않았다.
한 평가 시험의 passes/flags 검사도 남은 문제로 기록됐다. tomllib이 없는 인터프리터에서 검사가 건너뛰어진 상태를 통과로 취급한다는 내용이다. 이 실행에서 생성된 이슈는 기록 시점에 열려 있었다. 당시 전체 스위트가 통과한 환경에는 tomllib이 있었으므로, 그 결과를 다른 인터프리터에서의 건너뜀 처리까지 검증한 증거로 넓힐 수 없다.
실제 Claude 봇 댓글에 대해서도 확인 범위가 좁다. 첫 실행 당시 Claude GitHub 앱은 설치돼 있었지만 자동으로 게시하지 않았고, 어떤 PR에서도 Claude 봇 리뷰가 관찰되지 않았다. 관리형 Claude Code Review는 Team/Enterprise 전용이고 사용량 과금이라 활성화하지 않았다. claude-code-action은 API 키 또는 OAuth 토큰과 Actions 분이 필요해 워크플로우와 시크릿을 활성화하지 않았다. 유료 초과 사용은 금지다.
따라서 Claude 봇에 관한 가드는 실제 댓글이 나타날 때만 작동한다. 이번 시험은 합성 JSON으로만 이뤄졌고 실제 댓글의 형식을 확인한 실행은 없었다. 빨간 원 하나에 의존하므로 봇의 표기 형식이 바뀌면 규칙이 깨질 수 있다. 실제 댓글이 처음 나타날 때 형식을 확인하고 시험 입력을 갱신하기를 권장한다. 이 권장은 이미 수행한 검사가 아니다.
반대 방향의 누락도 코드에서 논리적으로 따라온다. Claude 봇이 빨간 원 없이 Important만 쓴 진짜 지적을 남긴다면 새 규칙은 그 지적을 차단하지 않는다. 실제로 그런 지적을 놓친 사례가 기록됐다는 뜻은 아니다. 단어만으로 Nit를 차단하던 오탐을 없애면서, 표식 없는 지적은 이 규칙이 잡지 못하게 됐다.
외부 문서의 확인 범위도 따로 적는다. 내가 읽은 GitHub의 PR 리뷰 댓글 문서는 예시 작성자 객체에 login과 type을 보여 주고 두 필드의 스키마를 문자열로 제시한다. 사용자 조회 문서의 예시에도 같은 필드가 있고 type은 문자열이다.
내가 읽은 두 페이지는 type의 가능한 값이나 [bot] 접미사를 설명하지 않는다. Bot이라는 값과 claude[bot] 형태는 이 글의 코드와 시험 입력이 쓰는 전제다. 읽은 문서만으로 그 의미를 확인한 것은 아니다. 로그인 정규식만 믿지 않고 문서에 나타난 type 필드도 함께 보는 설계를 권장하지만, 값의 의미는 별도 확인이 필요하다.
리뷰 결과의 근거 자체를 따로 살피는 문제는 AI 검증자의 지적을 그대로 고치면 안 되는 이유에서도 다뤘다. 여기서는 봇 지적을 받아들이기 전 단계에 초점을 맞췄다. 어떤 작성자와 표식을 차단 대상으로 셀지 정해도, 실제 입력 형식과 처리 기록이 확인돼야 상태 게시의 의미를 해석할 수 있다.
자주 묻는 질문
사람 계정의 빨간 지적은 왜 제외됐나?
이 스크립트의 해당 조건은 지정된 리뷰 봇의 지적을 대상으로 한다. 재측정에서 claude-reviewer는 타입이 User여서 새 판정의 대상이 아니었다. 사람의 지적이 중요하지 않다는 일반적인 판단은 아니다.
Nit에 Important가 들어가면 이제 어떻게 되나?
Claude 봇 댓글에 빨간 원이 없다면 그 단어만으로는 차단하지 않는다. 반대로 빨간 원 없는 실제 중요 지적도 이 규칙에서는 놓칠 수 있다. 그런 실제 누락 사례는 제공된 실행 기록에 없다.
현재 시험 파일은 전부 통과했나?
오늘 한 번 실행한 결과 봇 판정 시험은 모두 통과했다. 파일 전체로는 64개 중 61개가 통과했고 리뷰 문서 전환과 관련된 3개가 실패했다. 실패 원인은 조사하지 않았다.
실제 Claude 봇 댓글로 판정을 확인했나?
아니다. 해당 실행에서 Claude 봇 리뷰는 관찰되지 않았고 시험은 가짜 상태 디렉터리의 댓글 JSON을 사용했다. 실제 댓글이 처음 나타나면 표식과 입력 형식을 확인해 시험을 갱신하기를 권장한다.
관련 글과 출처
AI 검증자의 지적을 그대로 고치면 안 되는 이유는 지적의 근거를 대조하는 방법을 다룬다. 교차 검증을 처음 세우는 법은 검증 구성을 설명한다. 다른 기록은 프로그래밍 카테고리에서 볼 수 있다.
외부 자료는 PR 리뷰 댓글 REST 문서와 사용자 조회 REST 문서다. 두 문서에서 확인한 필드의 존재와 시험 입력에서 가정한 값의 의미는 서로 다른 조건이다.
아직 댓글이 없습니다.