배포 직후 측정이 거짓말하는 세 가지: 엣지 캐시, 브라우저 304, 새 도메인 DNS 캐시
배포 직후 Lighthouse CLS와 캐시 헤더가 서비스 상태가 아니라 측정 쪽 캐시를 보고 있던 세 사례를 기록 기준으로 정리한다.
배포 직후에 본 성능 수치와 캐시 헤더는 지금 서비스의 상태를 보여 준다고 믿기 쉽습니다. 이 글은 Cloudflare Workers 같은 엣지에 배포한 직후 Lighthouse의 CLS나 응답 캐시 헤더를 확인하는 개발자에게 맞춘 기록입니다. 제 다른 프로젝트인 개인 영상 워크플로 앱에서 홈 화면의 CLS를 고친 뒤, 측정값이 새 배포가 아니라 이전 상태를 보고 있던 사례를 정리합니다. 아래 수치는 그 프로젝트의 2026-07-25~26 기록값이며, 이 블로그의 상태가 아닙니다.
답부터 말하면 세 경우 모두 서비스 결함이 아니었습니다. 엣지 문서 캐시가 낡은 HTML을 돌려주어 Lighthouse가 옛 점수를 다시 보고했고, 브라우저에 남은 옛 304 캐시가 헤더를 낡은 값으로 보이게 했으며, 새 커스텀 도메인은 macOS 시스템 DNS 캐시의 IPv6 전용 항목 때문에 Node fetch가 실패했습니다. 이 글은 각 경우를 어떻게 구별했는지, 어떤 우회 수단을 썼는지를 기록에 적힌 범위 안에서 설명합니다.
먼저 한계를 적습니다. 기록에 없는 것은 쓰지 않았습니다. 배포 전후의 프로덕션 TTFB 비교는 기록에 없습니다. 기록은 이 항목을 트래픽이 쌓인 뒤 observability로 확인해야 할 것으로 남겼습니다. 71에서 93~96으로 올랐다는 점수가 몇 번의 측정이었는지, 그때 어떤 조건으로 측정했는지도 기록에 없습니다. 같은 기록에는 D1 복합 인덱스, Promise.all 병렬화, workerd에서 import.meta.env가 없어 생긴 결함도 있었지만, 측정 문제가 아니므로 이 글에서는 다루지 않습니다.
고친 것과 반려된 1차안
문제는 홈 화면 최상단의 추천 위젯이었습니다. 추천 데이터는 스트리밍으로 도착했고, 위젯이 나타나면 그 아래의 hero와 토픽 영역이 밀렸습니다. 기록의 측정에서 이 홈 화면의 CLS는 0.691이었습니다.
web.dev는 CLS의 기준을 이렇게 설명합니다. Good CLS values are 0.1 or less. Poor values are greater than 0.25. 같은 문서는 예상치 못한 이동이 보통 자원이 비동기로 로드되거나 기존 콘텐츠 앞에 DOM 요소가 동적으로 추가될 때 생긴다고 말합니다(web.dev의 CLS 문서, 2026-10-30 조회). 이 사례의 위젯은 두 번째 경우에 가깝다는 것이 제 해석입니다. 문서가 이 사례를 직접 다룬 것은 아닙니다.
처음 낸 안은 두 가지였습니다. 하나는 fallback에 min-height로 높이를 미리 잡아 두는 것이었고, 다른 하나는 토픽 그리드에 max-height와 스크롤을 걸어 높이의 상한을 두는 것이었습니다. 리뷰에서 이 안이 반려되었습니다. 추천 데이터가 null인 경우(일일 07:00 KST 배치 전)와 에러 분기에서는 페이지가 위로 약 740px 튀어 CLS가 약 0.9로 오히려 나빠졌기 때문입니다. 그래서 전부 되돌렸습니다.
기록은 이 실패에서 두 가지 교훈을 적었습니다. 첫째, 예약 높이는 정상, null, 에러의 모든 분기를 덮어야 합니다. 정상 분기에서만 높이가 맞아도 다른 분기에서 같은 문제가 다시 생깁니다. 둘째, 높이를 맞추는 것보다 구조를 바꾸는 쪽이 우선입니다. 기록은 그 구조적 해법을 마지막 요소로 옮기는 구조라고 적었습니다.
왜 정확히 740px인지는 기록에 없습니다. 예약 높이와 null 분기의 높이 차이에서 나왔을 것이라고 짐작할 수 있지만, 이것은 추정이며 제가 확인하지 않았습니다. CLS 0.9라는 값도 기록에는 리뷰에서 발견했다는 내용까지만 있고, 측정 도구나 조건은 없습니다.
채택한 안은 추천 위젯을 hero 아래로 옮기는 것이었습니다. 위젯이 hero 아래에 있으면 위젯이 나타나도 그 위에 있는 콘텐츠는 움직이지 않습니다. 이것은 구조에서 나온 추론입니다. 기록에는 정상 데이터와 null 데이터 양쪽에서 CLS가 0이었다고 적혀 있습니다. 에러 분기도 같은 방식으로 확인했다는 기록은 없으므로, 이 글에서는 정상과 null 두 분기만 검증된 것으로 씁니다.
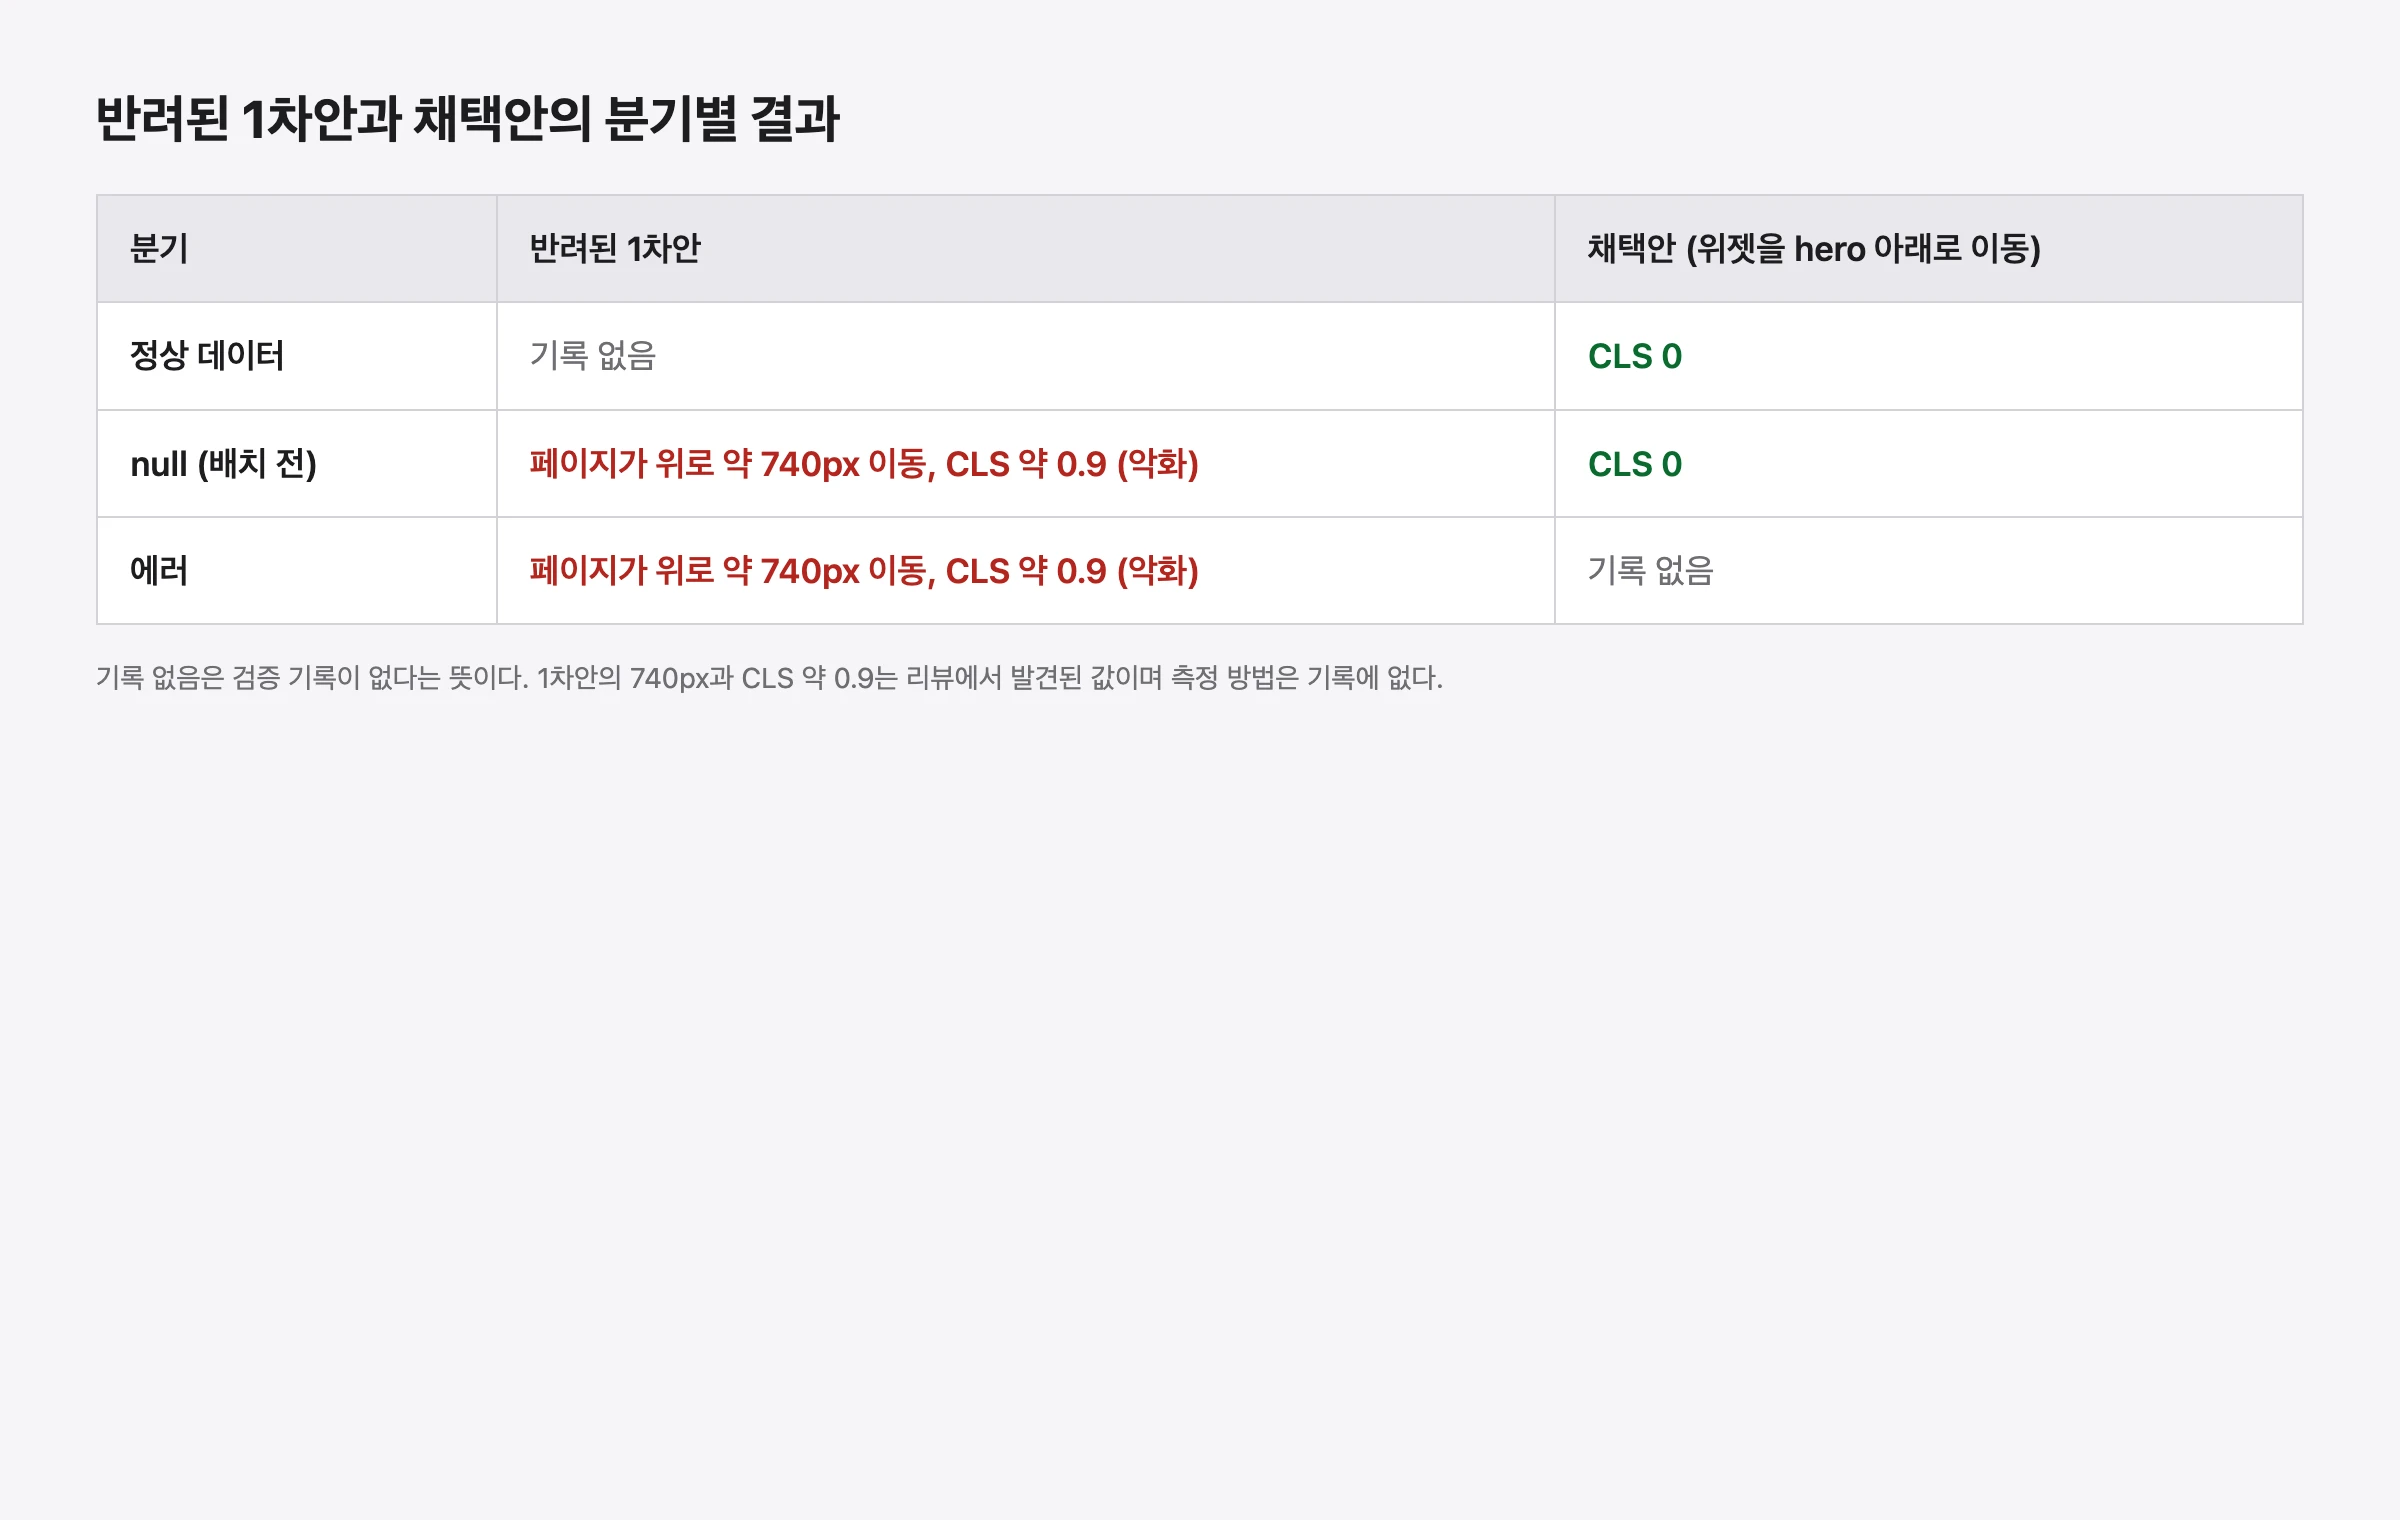
이 배포의 결과는 프로덕션 실측으로 기록되었습니다. 성능 점수는 71에서 93~96으로, CLS는 0.691에서 0으로 바뀌었습니다. 그런데 배포 직후 첫 측정은 이 결과를 보여 주지 않았습니다. 그 이야기는 다음 절에서 다룹니다.
수치가 낡았다는 것을 알아챈 방법
배포 직후 첫 Lighthouse는 76점과 CLS 0.691을 보고했습니다. 이 값은 배포 전 수치와 같았습니다. 점수가 한두 점 맞는 것은 우연일 수 있습니다. 그런데 CLS까지 소수점 셋째 자리가 같았습니다. 기록은 이 일치가 발각의 계기였다고 적었습니다.
이 기준은 기록의 사건에서 끌어낸 것입니다. 측정 대상이 실제로 바뀌었다면 점수와 CLS가 소수점까지 같을 가능성은 낮습니다. 그래서 배포 직후 수치가 직전 수치와 소수점까지 같으면, 점수를 해석하기 전에 측정이 어떤 응답을 받았는지부터 확인합니다. 이것은 통계 검정이 아니라 점검 순서를 정하기 위한 규칙입니다.
처방으로 기록에는 --disable-http-cache 또는 캐시버스트가 적혀 있습니다. 두 층은 다릅니다. 2026-10-30에 읽은 Lighthouse README에서 캐시와 관련된 CLI 옵션으로 확인한 것은 --disable-storage-reset뿐이었습니다(Lighthouse README). 이 옵션은 실행 전에 브라우저 캐시와 다른 저장소 API를 지우는 동작을 끄는 것입니다. 엣지 문서 캐시는 Lighthouse가 지우는 브라우저 쪽 저장소가 아니라 응답을 주는 앞단에 있으므로, 이 옵션으로는 해결되지 않습니다. 두 층을 나눠 본 것은 제 해석입니다.
기록의 --disable-http-cache는 제가 읽은 README의 옵션 목록에서는 확인하지 못했습니다. 그래서 이 글에서는 그 옵션이 존재한다고 쓰지 않습니다. 캐시버스트도 기록에 어떤 쿼리 문자열을 썼는지가 없어서, 이 글에서 재현 가능한 명령으로 제시할 수 없습니다.
같은 README에는 Lighthouse 실행에 네트워크와 CPU 스로틀링이 기본으로 적용된다는 설명도 있습니다. 기록의 71점과 93~96점이 같은 조건에서 측정되었는지는 기록에 없습니다. 그래서 점수 차이를 배포 효과로만 읽으면 안 됩니다.
세 캐시 층을 나눠 보기
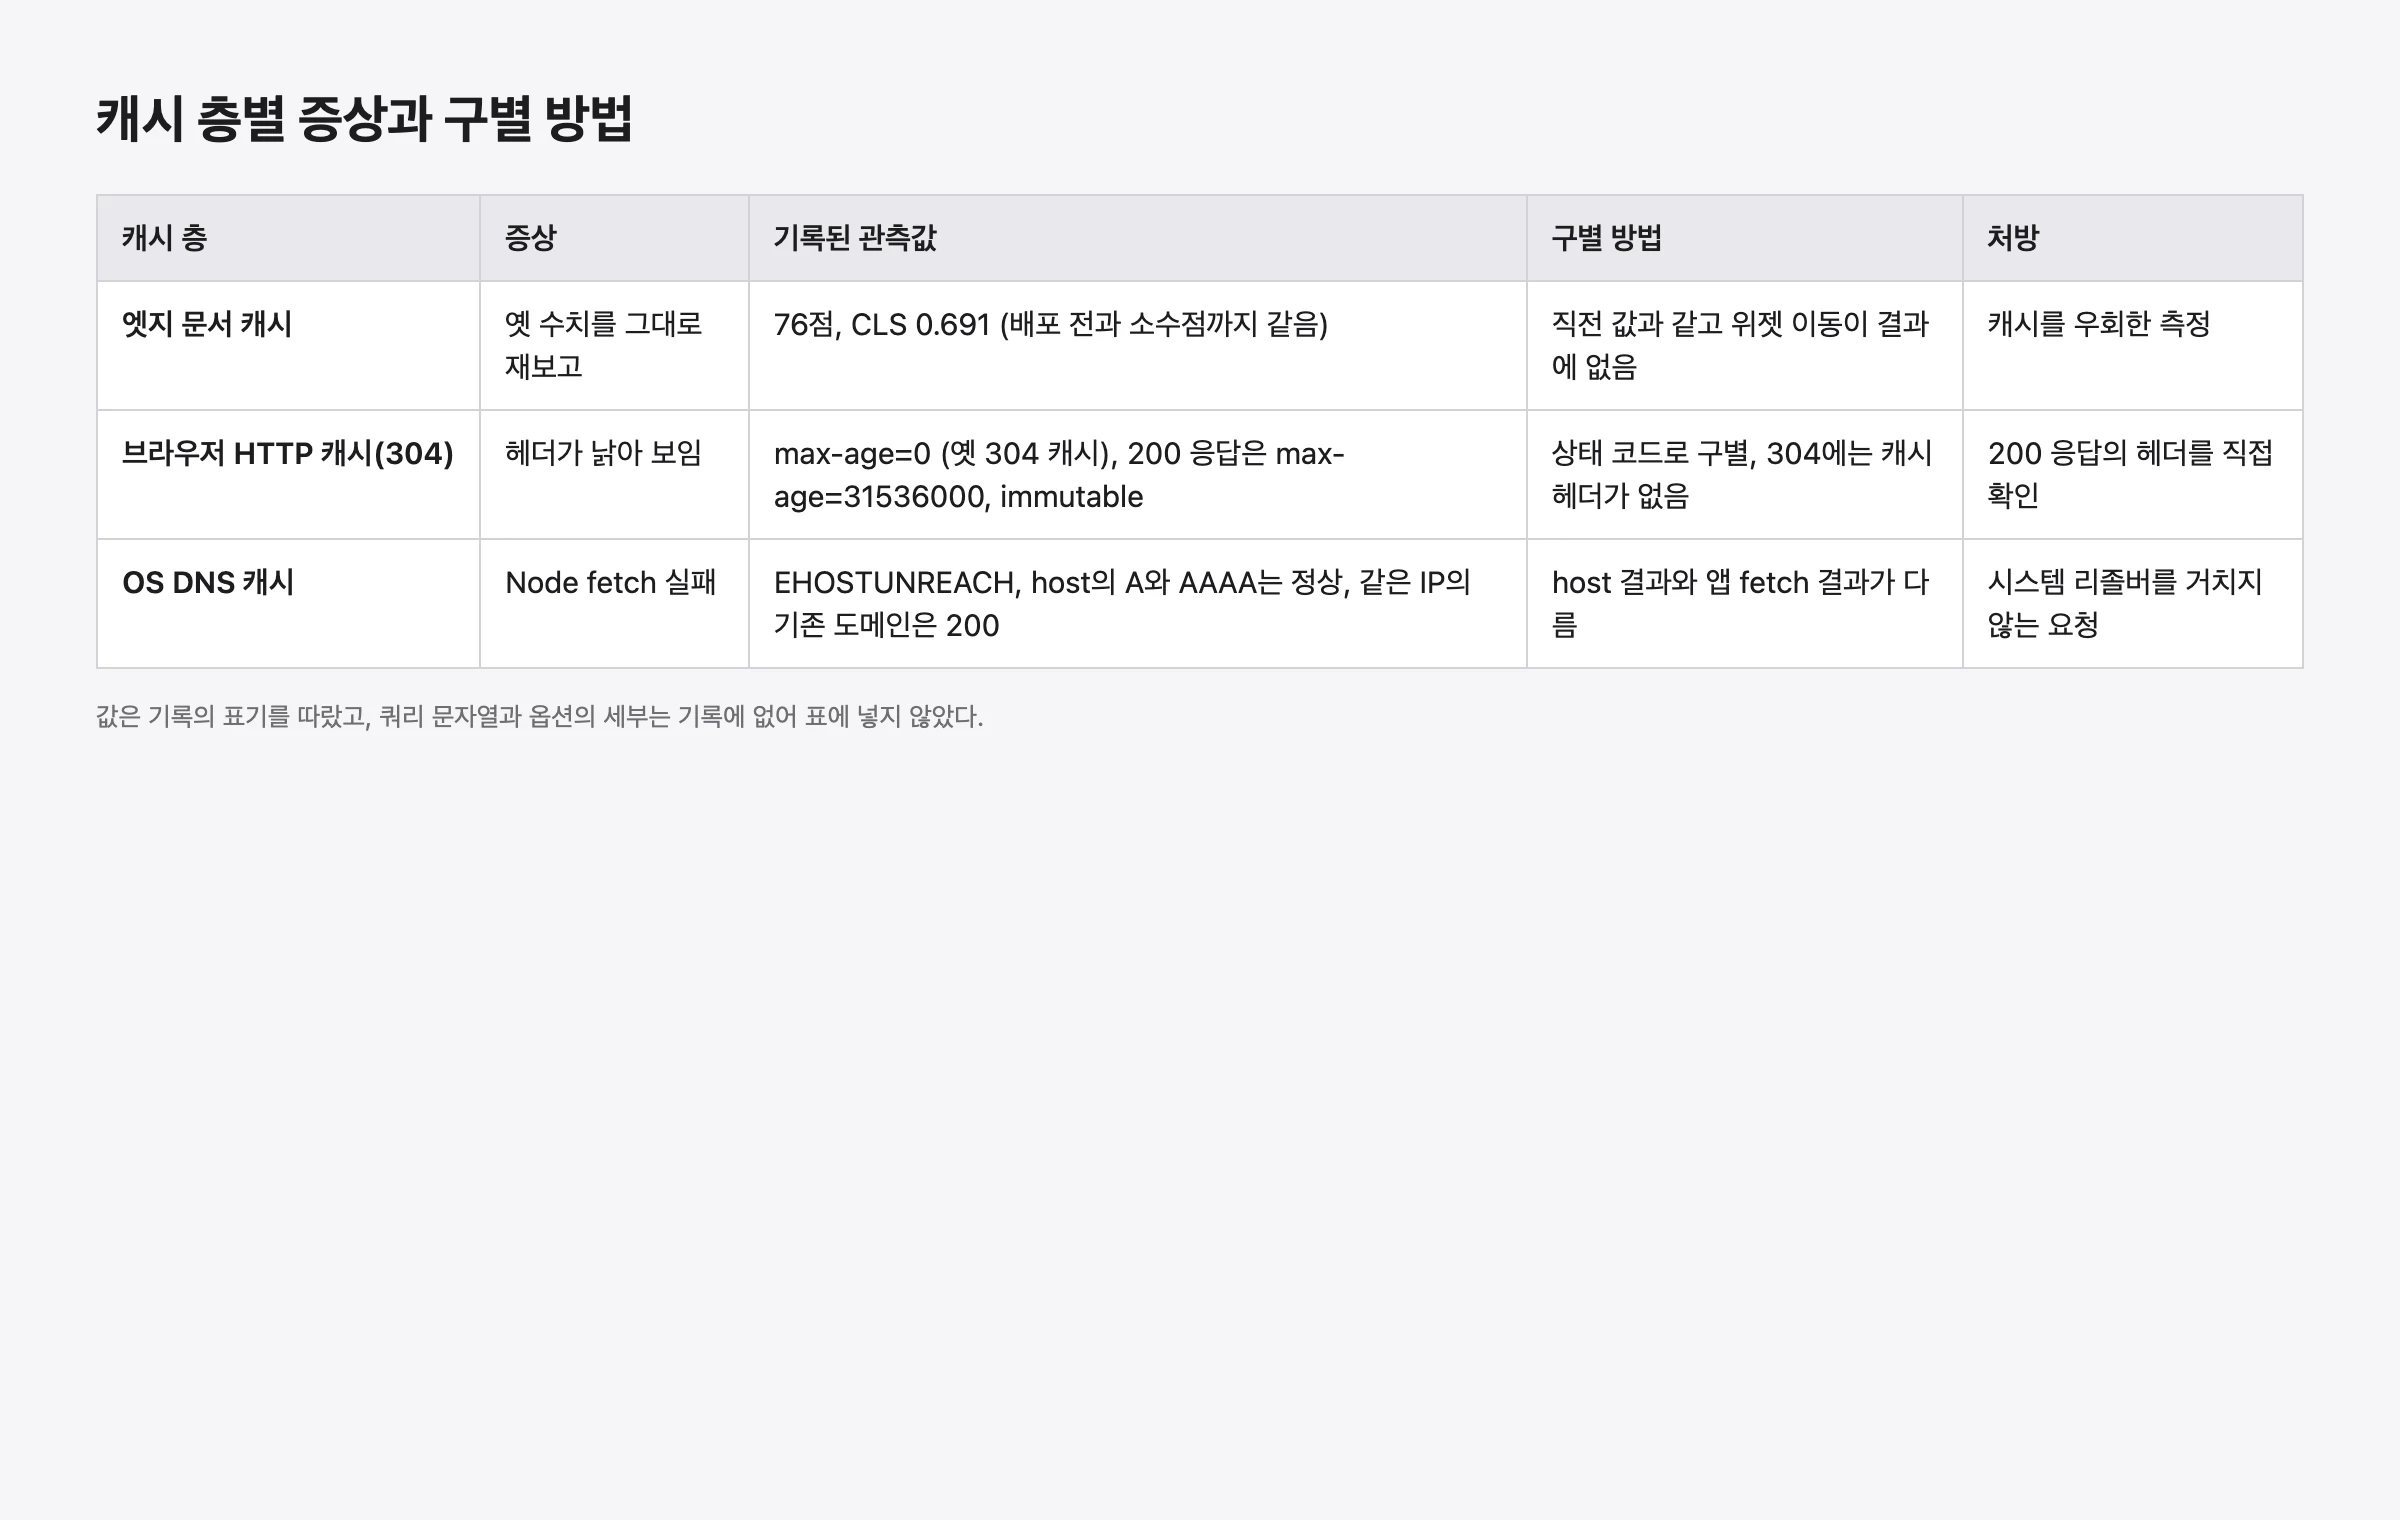
세 사례는 증상이 비슷하게 보입니다. 모두 배포가 반영되지 않은 것처럼 보입니다. 하지만 캐시가 있는 층이 다르므로 구별법과 처방도 다릅니다. 아래 그림은 기록된 값을 층별로 옮긴 것입니다.
엣지 문서 캐시: 같은 HTML이 옛 수치를 다시 보고한다
이 층의 증상은 측정 결과가 직전 결과와 소수점까지 같은 것입니다. 기록에서는 배포 직후 첫 Lighthouse가 엣지 캐시의 옛 문서를 읽어 76점과 0.691을 그대로 보고했습니다. 구별하는 방법은 두 가지입니다. 측정값이 직전 값과 같은지, 그리고 배포에서 바뀐 구조인 위젯의 위치가 결과에 반영되었는지를 봅니다. 기록의 경우 위젯 이동이 반영되지 않은 값이었습니다.
처방은 캐시를 우회하는 측정입니다. 기록은 이 처방을 --disable-http-cache 또는 캐시버스트로 적었습니다. 앞 절에서 말했듯이 Lighthouse의 저장소 초기화 옵션은 이 층을 우회하지 못합니다. 그래서 엣지 캐시를 의심할 때는 옵션보다 요청 URL을 바꾸는 쪽을 먼저 고려하는 것이 맞다는 것이 제 해석입니다.
브라우저 HTTP 캐시: 옛 304가 헤더를 낡아 보이게 한다
이 층의 증상은 응답 헤더가 기대와 다르게 보이는 것입니다. 기록에서는 프로덕션 자산을 확인할 때 max-age=0이 보였습니다. 기록은 이것을 브라우저에 남아 있던 옛 304 캐시라고 판단했습니다. 같은 자산의 200 응답 헤더는 cache-control: public, max-age=31536000, immutable이었습니다.
cache-control: public, max-age=31536000, immutable   (기록: /assets/*.css 200 응답)
cache-control: max-age=0                              (기록: 브라우저에 남은 옛 304 캐시에서 관찰)
구별은 응답 상태 코드를 보는 것입니다. 200 응답의 헤더가 맞으면 서비스 설정은 맞습니다. 304 응답에는 캐시 헤더가 붙지 않는다는 점도 기록에 남은 관찰로 적혀 있습니다. 기록은 원인을 applyHashedAssetCacheHeaders가 !response.ok일 때 일찍 반환하기 때문이라고 설명했습니다. 기록은 이미 immutable 헤더를 받은 브라우저는 재검증을 하지 않으므로 실질 영향이 작다고 판단했습니다. 이 판단은 기록 작성자의 판단이며, 제가 다시 검증하지 않았습니다.
처방은 응답을 직접 확인하는 것입니다. 아래는 제가 권장하는 확인 명령의 형태입니다. 기록에 있던 명령은 아닙니다.
curl -sI "https://<도메인>/assets/<파일>.css"OS DNS 캐시: 새 도메인이 시스템 리졸버에서만 실패한다
이 층의 증상은 Node fetch가 EHOSTUNREACH를 내는 것입니다. 이 사례의 새 커스텀 도메인은 Worker 설정의 routes에 custom_domain을 선언해서 만들었습니다. Cloudflare가 DNS 레코드(AAAA, proxied)와 TLS 인증서를 자동으로 만들었고, 대시보드에서 레코드를 따로 만들지 않았습니다.
기록에 따르면 macOS 시스템 DNS 캐시에 IPv6 전용 항목이 잡혀 있었습니다. 그래서 host 명령은 A와 AAAA를 정상으로 돌려주었지만, 앱의 fetch는 실패했습니다. 같은 IP를 가리키는 기존 도메인은 200을 돌려주었습니다. 이 대조가 기록에서 도메인 설정 문제가 아니라고 판단한 근거입니다.
host <새 서브도메인>구별하려면 세 가지 관찰을 함께 봅니다. host 결과가 정상인지, 같은 IP의 다른 도메인이 응답하는지, 시스템 리졸버를 거치지 않은 요청이 성공하는지입니다. 기록은 리졸버를 우회해 IP를 직접 지정하고 SNI와 Host 헤더를 맞춘 요청으로 검증을 끝냈습니다. 캐시 항목이 왜 IPv6 전용으로 잡혔는지는 기록에 없습니다. 제가 확인하지 않았으므로 원인은 추정으로만 남깁니다.
측정 뒤의 확인 순서
아래 순서는 기록에 있던 절차가 아닙니다. 세 사례를 놓고 제가 권장하는 순서입니다. 각 단계가 어느 층을 보는지도 함께 적었습니다.
- 점수와 CLS가 직전 수치와 소수점까지 같은지 봅니다. 같다면 점수를 해석하기 전에 다음 단계로 갑니다.
- 응답 헤더와 상태 코드를 봅니다. 200과 304를 구별하고, 304에는 캐시 헤더가 없을 수 있다는 점을 감안합니다.
- 캐시를 우회한 측정을 한 번 더 합니다. 우회 방법은 층마다 다르므로, 어느 층을 우회했는지 보고서에 적습니다.
- 새 도메인이라면 host로 A와 AAAA를 확인합니다. 앱의 fetch만 실패하면 시스템 리졸버를 거치지 않는 요청으로 같은 응답이 나오는지 봅니다.
- 측정 횟수와 조건을 함께 적습니다. 기록에도 서버 응답이 90~630ms로 흔들렸다는 관찰이 있었고, 콜드 isolate에서 나온 편차로 기록되었습니다. 한 번의 측정값으로 비교하지 않는 근거로 쓸 수 있습니다.
이 순서에서 3단계가 가장 쉽게 빠집니다. 우회했다고 적지 않으면 나중에 두 측정값을 비교할 때 어느 쪽이 캐시를 거쳤는지 알 수 없습니다. 기록의 사례에서도 71점과 93~96점이 같은 조건의 측정인지 확인되지 않았습니다. 그래서 저는 측정값을 적을 때 조건 세 가지, 곧 캐시 우회 여부, 측정 횟수, 직전 값과의 일치 여부를 한 줄로 함께 남기는 쪽을 권합니다. 이것은 기록에 있던 절차가 아니라 이 사례에서 제가 끌어낸 권장입니다.
확인하지 못한 것
이 글의 범위를 넘는 내용은 다음과 같이 남겨 둡니다.
- 배포 전후 프로덕션 TTFB 비교는 기록에 없습니다. 기록에는 트래픽이 쌓인 뒤 observability로 확인할 항목으로만 남아 있습니다.
- 71에서 93~96으로 바뀐 점수가 몇 번의 측정인지, 측정 조건이 무엇이었는지는 기록에 없습니다.
- 반려된 1차안의 CLS 0.9는 리뷰에서 발견했다는 기록만 있고 측정 방법이 없습니다.
- 채택안의 에러 분기 CLS는 검증 기록이 없습니다. 정상과 null 분기만 검증되었습니다.
- 740px이라는 점프 크기의 원인은 추정입니다.
- 304 응답의 헤더 누락이 실질 영향이 작다는 판단은 기록 작성자의 판단입니다. 제가 다시 검증하지 않았습니다.
남는 기준
배포 직후의 측정은 새 배포를 보고 있는지부터 확인해야 합니다. 이 기록에서 그 확인의 실마리는 점수가 아니라 소수점까지 같은 숫자였습니다. 점수가 달라졌다는 사실만으로 개선을 확인했다고 쓰지 않는 것이 이 사례들이 주는 기준입니다. 헤더는 상태 코드와 함께 봐야 하고, 새 도메인의 실패는 도메인 설정보다 시스템 리졸버 쪽 캐시를 먼저 의심하게 합니다.
캐시 헤더를 설계하는 쪽의 문제, 특히 immutable 헤더를 폴백 경로와 함께 쓸 때의 문제는 immutable 캐시와 폴백의 오염 문제를 다룬 글에서 이어서 볼 수 있습니다. 이 글은 측정 쪽의 캐시만 다뤘습니다.
자주 묻는 질문
배포 직후 Lighthouse 점수가 이전과 똑같으면 무엇부터 봐야 하나요?
점수 해석보다 측정이 새 응답을 받았는지부터 봅니다. 기록의 사례에서 점수와 CLS가 소수점 셋째 자리까지 같았던 것이 그 신호였습니다. 같은 조건으로 캐시를 우회한 측정을 한 번 더 하고, 두 결과가 같은 방향을 보이는지 확인합니다.
캐시 헤더에 max-age=0이 보이면 서비스가 잘못된 것인가요?
반드시 그렇지는 않습니다. 기록에서 max-age=0은 브라우저에 남은 옛 304 캐시에서 보였고, 같은 자산의 200 응답은 올바른 헤더를 가지고 있었습니다. 상태 코드를 먼저 구별하고, 200 응답의 헤더를 다시 확인합니다.
새 커스텀 도메인에서 fetch가 EHOSTUNREACH를 내면 도메인 설정을 의심해야 하나요?
기록의 사례에서는 아니었습니다. host 결과의 A와 AAAA가 정상이었고, 같은 IP를 가리키는 기존 도메인은 200을 돌려주었습니다. 이 경우 시스템 DNS 캐시를 의심하고, 리졸버를 거치지 않은 요청으로 같은 응답이 나오는지 확인합니다.
이 글의 수치로 프로덕션 성능이 좋아졌다고 말할 수 있나요?
CLS가 0.691에서 0이 된 것은 기록된 측정입니다. 하지만 점수 71에서 93~96으로의 변화는 측정 횟수와 조건이 기록에 없어서, 그 범위를 확정된 개선치로 쓰기는 어렵습니다. 프로덕션 TTFB 비교도 기록에 없습니다.
아직 댓글이 없습니다.