ICLR 2026 연구 읽기: 기관 통계·에이전트 기억·옵티마이저
ICLR 2026 비공식 기관 소속 통계의 한계와 MemAgent·ReasoningBank 기억 실험, Muon 옵티마이저 연구를 정리했다. 실무 도입 전 확인할 데이터 공개 범위와 실험 조건을 함께 짚는다.
이 글의 연구 선정과 구성은 YJ가 작성한 하이젠버그의 ICLR 2026 보고서를 참고했다. 각 연구의 내용과 적용 범위는 아래에 연결한 원자료를 기준으로 구분한다.
연구자 Dmytro Lopushanskyy가 공개한 비공식 분석에 따르면, ICLR 2026에서 논문 수가 많은 상위 50개 기관의 누적 논문 수를 국가별로 묶었을 때 중국 본토가 43.7%, 미국이 31.9%였다. 분석자는 5천 편이 넘는 채택 논문의 OpenReview 정보와 PDF 소속을 추출하고 한 논문에서 같은 기관은 한 번만 셌다고 설명한다. 다만 이 수치는 ICLR의 공식 저자 국적 통계도, 전체 채택 논문의 국가별 점유율도 아니다. 원자료와 세부 정제 기준이 게시물 본문에 공개돼 있지 않으므로 연구 지형을 확정하는 숫자가 아니라 기관 소속 분포를 살펴보는 보조 신호로 읽어야 한다. 하이젠버그 보고서는 이 통계와 함께 딥시크, 큐원, GLM, Kimi, MiniMax, MiMo 같은 중국 오픈 웨이트(open-weight, 모델 가중치 파일을 공개해 누구나 내려받아 쓸 수 있게 하는 방식) 모델을 다룬다. 기관 소속 집계와 모델 공개 방식은 서로 다른 지표이므로 각각의 근거를 따로 살펴야 한다.
기관 소속 통계로 알 수 있는 것과 없는 것
기관 소속별 논문 수는 연구 활동을 살펴보는 한 지표다. 이 분포만으로 어떤 기업이 경쟁사 모델의 답변을 학습에 사용했는지, 특정 국가의 모델 성능이 왜 높아졌는지를 설명할 수는 없다. 학습 데이터의 출처를 판단하려면 해당 모델의 기술 보고서와 데이터 공개 범위, 이용 조건을 별도로 확인해야 한다.
실무에서는 모델의 국적이나 공개 방식보다 확인 가능한 조건부터 비교하는 편이 낫다. 가중치를 받을 수 있는지, 상업적 이용이 허용되는지, 입력 데이터가 어디로 전송되는지, 제시된 평가를 재현할 수 있는지를 모델별로 적는다. 공개되지 않은 학습 과정을 추정으로 채우지 않고, 도입 판단에서 남는 불확실성으로 기록하는 절차다.
통계 해석의 한계: 위 비공식 수치는 상위 50개 기관을 대상으로 한 집계다. 저자의 국적, 전체 채택 논문의 국가별 비중, 기업별 모델 성능을 나타내지 않는다. 따라서 이 글에서는 국가 순위 그래프로 일반화하지 않는다.
실무자에게 이 지형이 왜 중요할까. 어떤 벤더의 모델을 선택하느냐가 곧 데이터 출처와 라이선스 리스크, 가격 경쟁력을 정하기 때문이다. 오픈 웨이트 모델이 늘수록 선택지는 넓어지지만 그 모델이 어디서 왔는지 따지는 습관도 같이 필요해진다. 성능 벤치마크 표 한 장만 보고 벤더를 고르면 라이선스 조건이나 데이터 공개 범위 같은 도입 조건을 놓칠 수 있다.
에이전트는 왜 어제 배운 걸 잊을까
하이젠버그 보고서가 구분한 두 층위는 모델의 학습 결과와 서비스가 별도로 보관하는 기록이다. 새 대화에 이전 내용을 넘겨 주는 저장소나 검색 기능이 없다면, 에이전트는 지난 작업을 자동으로 이어받을 수 없다. 메모리 기능이 있는 서비스도 어떤 내용을 저장하고 다음 요청에 전달하는지는 별도의 설계 문제다.
하이젠버그 보고서가 소개한 외부 메모 방식에서는 다음 작업에 필요한 내용을 모델 밖에 저장하고 요청에 맞춰 다시 읽힌다. 이전 대화를 참고했다는 사실만으로 모델의 가중치가 갱신됐다고 볼 수는 없다. 실무에서는 메모의 저장 위치, 불러오는 조건, 삭제 방법을 확인해야 한다.
하이젠버그 보고서도 메모 분량이 늘어날 때의 부담을 짚는다. 긴 작업일수록 기록이 쌓이지만 모두 다시 읽히면 처리 비용이 늘고, 지나치게 줄이면 필요한 맥락이 빠진다. 따라서 코딩 에이전트처럼 여러 작업을 이어 가는 경우에는 다음 요청에 필요한 정보를 고르는 규칙이 중요하다.
메모장을 고치는 두 가지 실험
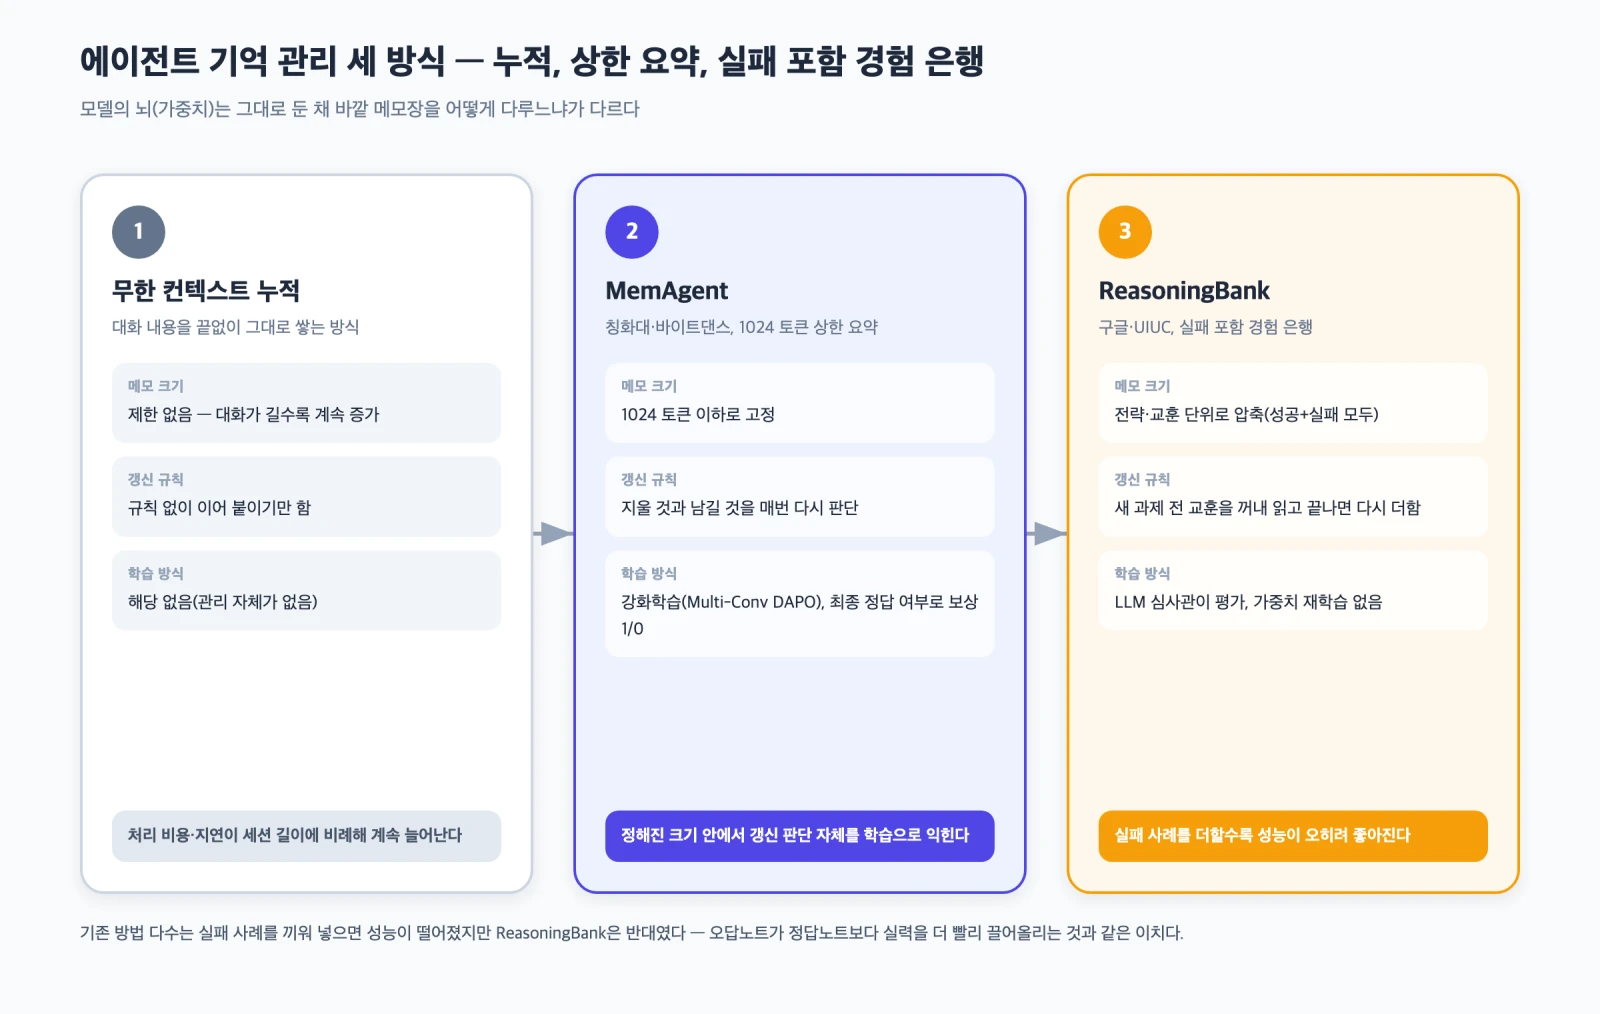
칭화대와 바이트댄스 연구자들이 낸 MemAgent 논문은 메모장 길이를 1024 토큰 이하로 못 박는다. 새 정보가 들어오면 지울 것은 지우고 덧붙일 것은 덧붙이는 판단이 필요해진다. 이 판단 자체를 강화학습으로 가르쳤다. 최종 답이 맞았는지 틀렸는지에 따라 보상 1 또는 0을 주고 그 보상을 조금씩 읽고 메모한 전 과정에 되먹인다. 따라서 마지막 답의 정확도가 중간의 메모 갱신 판단을 학습시키는 신호가 된다.
구글과 UIUC 연구자들의 ReasoningBank 연구는 작업 결과에서 다른 과제에도 적용할 전략을 추출한다. 개별 행동을 그대로 저장하는 대신 성공과 실패에서 얻은 교훈을 기록한다. 연구진은 기존 방법에서 실패 사례를 추가할 때 성능이 나빠진 것과 달리 ReasoningBank에서는 실패 사례를 더할수록 성능이 좋아졌다고 설명한다.
하이젠버그 보고서에 따르면 ReasoningBank에서는 별도의 LLM이 작업 결과를 평가해 외부 기록에 남길 교훈을 고른다. 갱신 대상은 그 기록이며, 이 과정에서 에이전트 모델의 가중치를 다시 학습시키지 않는다.
하이젠버그 보고서는 새 작업을 시작할 때 관련 교훈을 검색해 참조하고, 작업이 끝나면 결과에서 다음에 쓸 교훈을 추출해 저장한다고 설명한다. 이후 작업은 갱신된 기록을 다시 사용할 수 있다. 이 반복은 외부 기록을 바꾸는 절차이며 모델 가중치의 재학습과는 구분된다.
에이전트 세션이 길어질수록 메모를 얼마나, 어떻게 압축할지 실무에서도 반복해서 부딪힌다. 에이전트 기억을 압축하는 문제를 실제로 다뤄 본 적이 있다면 MemAgent의 1024토큰 상한이나 ReasoningBank의 실패 포함 전략이 남 이야기로 안 들릴 것이다.
하이젠버그 보고서가 이어서 소개한 SkillOpt 논문에서는 에이전트가 참고하는 자연어 업무 지침인 스킬 문서를 성공과 실패 기록에 맞춰 수정한다. 수정본은 검증 문제에서 성능이 나아졌을 때 채택한다. ReasoningBank과 마찬가지로 외부 기록을 고치지만 대상은 교훈 기록이 아니라 업무 지침이다. 학습 단계도 구분해야 한다. MemAgent는 메모를 갱신하는 동작을 강화학습으로 훈련한다. ReasoningBank과 여기서 설명한 SkillOpt의 문서 개선은 모델 가중치 대신 외부 기록을 바꾸는 접근이다. 모두 외부 기록을 활용하지만, 세 연구가 전부 가중치 학습을 하지 않는다고 묶을 수는 없다.
| 접근 | 메모 크기 | 갱신 방법 | 특징 |
|---|---|---|---|
| 무한 컨텍스트 누적 | 제한 없음 | 규칙 없이 계속 쌓기만 함 | 대화가 길어질수록 처리 비용과 지연이 같이 늘어난다 |
| MemAgent | 1024 토큰 이하로 고정 | 강화학습(Multi-Conv DAPO)으로 갱신 판단을 학습 | 정해진 크기 안에서 지우고 덧붙이는 균형을 스스로 익힌다 |
| ReasoningBank | 전략·교훈 단위로 압축 | LLM 심사관이 성공·실패를 평가해 메모만 갱신(가중치 재학습 없음) | 실패 사례를 더할수록 성능이 오히려 좋아진다 |
모델을 가르치는 방식도 새로 짜인다
모델 학습에는 가중치를 갱신하는 최적화 알고리즘도 중요하다. Adam은 각 파라미터에 대한 갱신값을 계산하는 널리 쓰이는 방법이다. Muon 관련 연구는 행렬 형태의 가중치를 갱신할 때 방향 구조를 어떻게 다룰지에 초점을 맞춘다.
Muon은 선형층의 gradient나 momentum 행렬을 직교화(orthogonalization, 행렬의 방향을 서로 겹치지 않게 정리하는 계산)한 방향으로 업데이트한다. 하이젠버그 보고서는 ICLR 2026에 나온 한 논문이 이 차이를 트랜스포머의 기억 구조 관점에서 분석한다고 소개한다. 보고서에 따르면 그 논문은 중요한 기억이 담긴 가중치를 Muon이 Adam보다 효과적으로 갱신하는 이유를 설명한다.
하이젠버그 보고서가 다룬 Muon 수렴 증명 논문의 쟁점은 직교화의 정확한 계산과 실제 구현에 쓰이는 근사 계산 사이의 차이다. 정확한 계산에는 SVD가 필요하지만 구현은 비용을 줄이기 위해 뉴턴-슐츠 반복(Newton–Schulz iteration)을 사용한다. 논문은 유한 번 반복하는 근사 방식에서도 수렴함을 보이고, 정확한 SVD를 사용하는 경우와 수렴률을 비교한다.
하이젠버그 보고서가 이어서 소개한 The Polar Express 논문은 ICLR이 Honorable Mention으로 발표한 연구다. 뉴턴-슐츠 반복의 초기 수렴 문제를 다루며, 행렬곱으로 계산할 수 있는 다항식을 각 단계에 맞게 고른다. GPT-2를 FineWeb 데이터로 학습한 실험 결과를 제시한다. 따라서 이 결과를 다른 모델이나 학습 환경에 적용할 때는 논문의 계산 조건과 실험 조건을 함께 확인해야 한다.
실무에서 옵티마이저를 비교할 때는 논문에 제시된 수렴 분석과 학습 실험을 구분해야 한다. 특정 계산이 더 효율적이라는 결과만으로 자신의 모델에서 같은 비용 절감이나 성능 개선이 난다고 단정할 수 없다. 모델 구조, 구현 방식, 장비 조건을 맞춘 검증이 필요하다.
실무자가 오늘 확인할 것
오픈 웨이트 모델을 고를 때도 데이터 공개 범위와 이용 조건을 따로 확인해야 한다. 메모장 관리 방식은 에이전트가 하루를 넘어 계속 일할 수 있는지를 가른다.
- 새 AI 도구를 고를 때 그 모델이 어느 데이터로 어떻게 학습됐는지 한 번은 따져 본다.
- 에이전트 세션이 길어지는 프로젝트라면 메모장 크기 제한과 갱신 규칙을 미리 정해 둔다.
- 실패 로그를 버리지 않는다. ReasoningBank의 결과가 보여주듯 실패 기록이 오히려 성능을 끌어올릴 수 있다.
- 학습 비용이 부담스러우면 Adam과 Muon 관련 연구의 수렴 분석·실험 조건을 자신의 모델·장비 조건과 대조한다.
- 모델 하나의 벤치마크 순위보다 그 모델을 둘러싼 데이터 확보 방식과 연구 생태계까지 함께 확인한다.
세 갈래 모두 아직 현재진행형이고 결론이 난 이야기가 아니다. 메모장 갱신 규칙은 작업마다 다시 맞춰야 한다. Muon 계열 옵티마이저도 논문의 실험 조건과 자신의 모델·장비 조건을 대조한 뒤 검증해야 한다. 이 세 흐름이 실제 제품에 얼마나 빠르게 들어오는지 지켜보는 일이 남은 숙제다. 관련 실무 기록은 프로그래밍 카테고리에 계속 모아 둔다.
자주 묻는 질문
이전 대화를 기억하는 것처럼 보이면 모델 가중치에 새 기억이 생긴 건가요?
아니다. 글이 다루는 방식에서는 대화의 중요 내용을 외부 메모에 저장하고 새 대화가 그 메모를 다시 읽는다. 모델 내부 가중치에 새 기억이 새겨진 것이 아니므로, 무엇을 남기고 버릴지 정하는 메모 갱신 규칙이 필요하다.
MemAgent와 ReasoningBank은 메모를 어떻게 다르게 갱신하나요?
MemAgent는 메모장을 1024토큰 이하로 제한하고 최종 정답 보상을 전 과정에 되먹여 갱신 판단을 학습한다. ReasoningBank은 성공과 실패에서 전략·교훈을 뽑아 LLM 심사관이 메모만 고치며 모델 가중치는 다시 학습하지 않는다.
Muon 관련 연구만으로 대규모 상용 서비스에 바로 도입해도 되나요?
아직 이 글만으로 전면 도입을 권할 수 없다. 글은 뉴턴-슐츠 근사의 수렴 증명과 일부 학습 실험을 소개하지만, 자신의 모델·장비 조건에서 같은 결과가 나오는지는 별도로 확인해야 한다.
2026년 9월 6일 정정: 기관 소속 통계를 저자 국적 통계로 표현한 그림을 제외하고, 출처가 확인되지 않은 기업·산업 단정을 삭제했습니다. MemAgent의 강화학습과 외부 메모 갱신의 차이도 바로잡았습니다.
아직 댓글이 없습니다.