모델이 쓴 프롬프트가 검증 장부 줄을 위조할 수 있었다: 작성자 인계 훅의 통과 범위와 해제 조건을 좁힌 기록
작성자와 검증자를 다른 벤더로 나누는 훅에서 모델이 표식 줄을 직접 쓸 수 있다는 보안 지적이 나왔다. 통과 범위를 좁히고 echo 우회를 고친 과정과 열린 한계를 정리했다.
작성자와 검증자를 서로 다른 벤더로 나누는 규칙을 에이전트 훅으로 강제하려고 했더니, 규칙을 지키게 할 표식 줄을 모델이 직접 써 넣을 수 있다는 지적이 리뷰에서 나왔다. 나는 이 보안 지적을 기각하지 않고 수정했다. 표식이 통과하는 범위를 검증자 유형과 이미 실행된 결정을 전달하는 코디네이터로 좁혔고, 검증 대기 장부는 상대 벤더의 리뷰가 끝난 뒤에만 지우게 바꿨다.
이 글은 2026-11-04에 닫힌 하네스 작업 기록에서 옮긴 것이다. 모든 수치와 결함은 그 실행 기록에 적힌 값이고, 이번에 새로 재현하지 않았다. 아래에 나오는 코드 조각은 실패 유형을 설명하려고 내가 새로 쓴 합성 예시이며 실제 훅 코드가 아니다.
무엇을 만들었고 무엇을 확인했나
만든 것은 하네스 플러그인에 들어가는 작성자 인계 훅이다. 하위 에이전트를 띄울 때 자식 프롬프트에 작성자 벤더 줄과 디스패치 식별 줄을 실어 보낸다. 작업이 끝나면 결과에 “검증 대기” 표식을 남기고, 작성 레인에서는 GPT 계열을 작성자로 쓰는 결정을 거부한다. 표식의 이름과 필드 이름은 내가 하네스 안에서 정한 약속이고 Claude Code가 제공하는 기능이 아니다.
동기는 단순했다. 작성한 쪽이 자기 결과를 검증하지 않도록 벤더가 다른 상대가 한 번 리뷰해야 한다. 그 사실을 사람이 기억하는 대신 장부에 남기고, 상대 리뷰가 끝나면 장부에서 지우고 싶었다. 같은 검증 규칙이 왜 필요한지는 서로 다른 벤더가 코드를 교차 검증하는 구조에서 먼저 정리했다.
이번 실행에서 확인한 범위는 이렇다. 훅의 단위 테스트와 점검은 통과했다. bun 테스트 870개 전부, 셸 테스트 89개 전부가 통과했고 타입 검사와 린트 오류는 0이었다. 활성화 뒤 실제 세션에서는 자식 프롬프트에 작성자 벤더 줄이 실렸고, 결과에 작성자 Claude와 상대 GPT를 적은 검증 대기 표식이 실렸다. 반면 GPT 결정을 거부하는 동작은 실제 세션에서 시험하지 못했다. 그 동작은 단위 테스트만 근거로 삼았고, 이 차이는 한계 절에서 다시 다룬다.
훅을 쓰기 전에 계약부터 확인했다
가장 먼저 걱정한 것은 훅이 다시 쓴 프롬프트를 에이전트 생성 도구가 실제로 따르느냐였다. 이 전제가 틀리면 나머지 설계가 전부 의미를 잃는다. 그래서 시험을 쓰기 전에 계약 프로브를 돌려 이 동작을 확인했고, 판정은 지원됨이었다.
같은 프로브에서 모듈 쪽 제약도 확인했다. 훅 설정 파일에 모듈 항목을 추가해야 하고, 모듈은 상대 경로의 파일과 Claude Code가 제공하는 모듈만 불러올 수 있으며 node:fs는 쓰지 않는다. 플러그인 시험 명령은 *.test.ts 파일을 실행한다. 정식 플러그인 타입 계약은 당시 버전 2.1.318에서 쓸 수 없어서 실제 동작으로 판정했다.
Claude Code 훅 문서는 PreToolUse를 “Claude가 도구 매개변수를 만든 뒤, 도구 호출을 처리하기 전”에 실행되는 훅으로 설명한다. 열람일은 2026-11-09다. 같은 문서에서 Bash 도구의 입력은 command 필드에 실리고, 훅은 표준 입력으로 JSON을 받는다. 이 구조 때문에 훅이 믿을 수 있는 것은 도구 이름과 인자뿐이다. 인자 안에 무엇이 들어 있는지는 모델이 만든 값이다.
리뷰가 지적한 위조 경로
시험 PR에 대한 Claude 리뷰가 P2 보안 지적을 냈다. 모델이 쓴 프롬프트가 디스패치 줄과 검증자 쪽 줄을 직접 포함할 수 있다는 내용이었다. 그러면 모델이 작성 레인의 거부 검사를 건너뛰게 만들거나, 검증 대기 항목이 지워지게 만들 수 있다. 훅이 자기가 넣은 줄과 모델이 쓴 줄을 구별하지 못하는 구조였다.
핵심 판단: 표식은 훅이 넣었다는 사실만 신뢰 근거가 된다. 프롬프트 안에 같은 모양의 문자열이 있다고 해서 같은 권한을 주면 안 된다.
OWASP의 프롬프트 인젝션 항목은 간접 프롬프트 인젝션을 LLM이 웹사이트나 파일 같은 외부 출처의 입력을 받는 경우로 설명한다. 열람일은 2026-11-09다. 같은 항목의 완화책에는 신뢰할 수 없는 내용을 구분해 표시하라는 항목이 있다. 이 사례는 외부 공격이 아니라 같은 시스템 안의 다른 모델 출력이라는 점이 다르다. 그래도 “텍스트 안의 지시 모양을 권한으로 취급하지 않는다”는 방향은 같다. 이 대응은 내 해석이며 OWASP가 이 사례를 직접 다루는 것은 아니다.
나는 이 지적을 기각할 수도 있었다. 하네스의 모델은 내 지시를 받는 내부 에이전트이고, 악의가 없다고 가정할 수도 있었다. 하지만 이 장부의 목적은 모델의 선의와 상관없이 검증이 빠지지 않게 하는 것이다. 모델이 실수로 줄을 흉내 내도 같은 우회가 생긴다. 그래서 결정은 기각이 아니라 수정이었다.
수정은 두 갈래였다. 첫째, 표식을 신뢰하는 범위를 검증자 유형과, 작성자 결정이 이미 실행된 알려진 경우의 코디네이터로 좁혔다. 둘째, 검증 대기 항목은 상대 리뷰가 끝난 뒤에만 지우게 했다. 이 두 조건이 위 위조 경로 두 가지에 각각 대응한다.
장부를 지우는 조건을 명령 문자열에서 떼어 냈다
논리 리뷰는 별도의 실제 결함을 찾았다. echo로 감싼 codex 명령이 검증 대기 항목을 지울 수 있었다. 훅은 Bash 명령 문자열에서 리뷰 도구 호출을 찾아 “리뷰가 시작됐다”고 판단했는데, 문자열에 그 명령이 들어 있기만 하면 실제로 실행되지 않아도 장부가 비워졌다. 정정은 한 번이었고, 해제 로직을 clearByCommand 한 곳으로 모았다.
이 결함이 어떤 종류인지 합성 예시로 보인다. 아래 코드는 실제 훅이 아니라 같은 실수를 그대로 옮긴 가상의 함수다.
// 합성 예시: 문자열 포함 여부로 "리뷰가 실행됐다"고 판단한다
function looksLikeReview(command: string): boolean {
  return command.includes("codex exec");
}

looksLikeReview("codex exec review --base develop");      // true (실제 실행)
looksLikeReview('echo "codex exec review --base develop"'); // true (출력만 한다)
두 호출은 문자열 검사에서 똑같이 참이다. 하지만 두 번째는 문장을 화면에 찍을 뿐 리뷰를 실행하지 않는다. 훅이 보는 입력이 명령 문자열 하나뿐이면 이 둘을 구별하려고 문자열 규칙을 계속 덧붙이게 된다. 나는 문자열에서 실행 여부를 추정하는 방식 자체가 약하다고 판단했다. 이 판단은 기록된 결함 한 건에 대한 해석이다.
이 방향은 훅 문서가 말하는 PostToolUse와 맞닿아 있다. 문서는 PostToolUse 입력에 도구에 보낸 인자인 tool_input과 도구가 돌려준 결과인 tool_response가 함께 들어 있다고 설명한다. 명령이 실행됐는지는 인자만 봐서는 알 수 없고 결과까지 봐야 한다. 다만 기록에는 정정이 이 입력을 쓰도록 바뀌었다는 내용이 없다. 기록에서 확인되는 것은 해제 로직을 한 함수로 모았다는 사실까지다.
| 구분 | 지적 전 | 정정 뒤 |
|---|---|---|
| 프롬프트의 표식 줄 | 모델이 쓴 줄도 훅이 넣은 줄과 같게 처리 | 검증자 유형과 이미 실행된 결정의 코디네이터에만 통과 |
| 장부 해제 시점 | 검증 도구 호출이 보이면 해제 | 상대 리뷰가 끝난 뒤에만 해제 |
echo로 감싼 명령 | 장부를 지울 수 있었다 | 해제 로직을 clearByCommand로 모아 정정 |
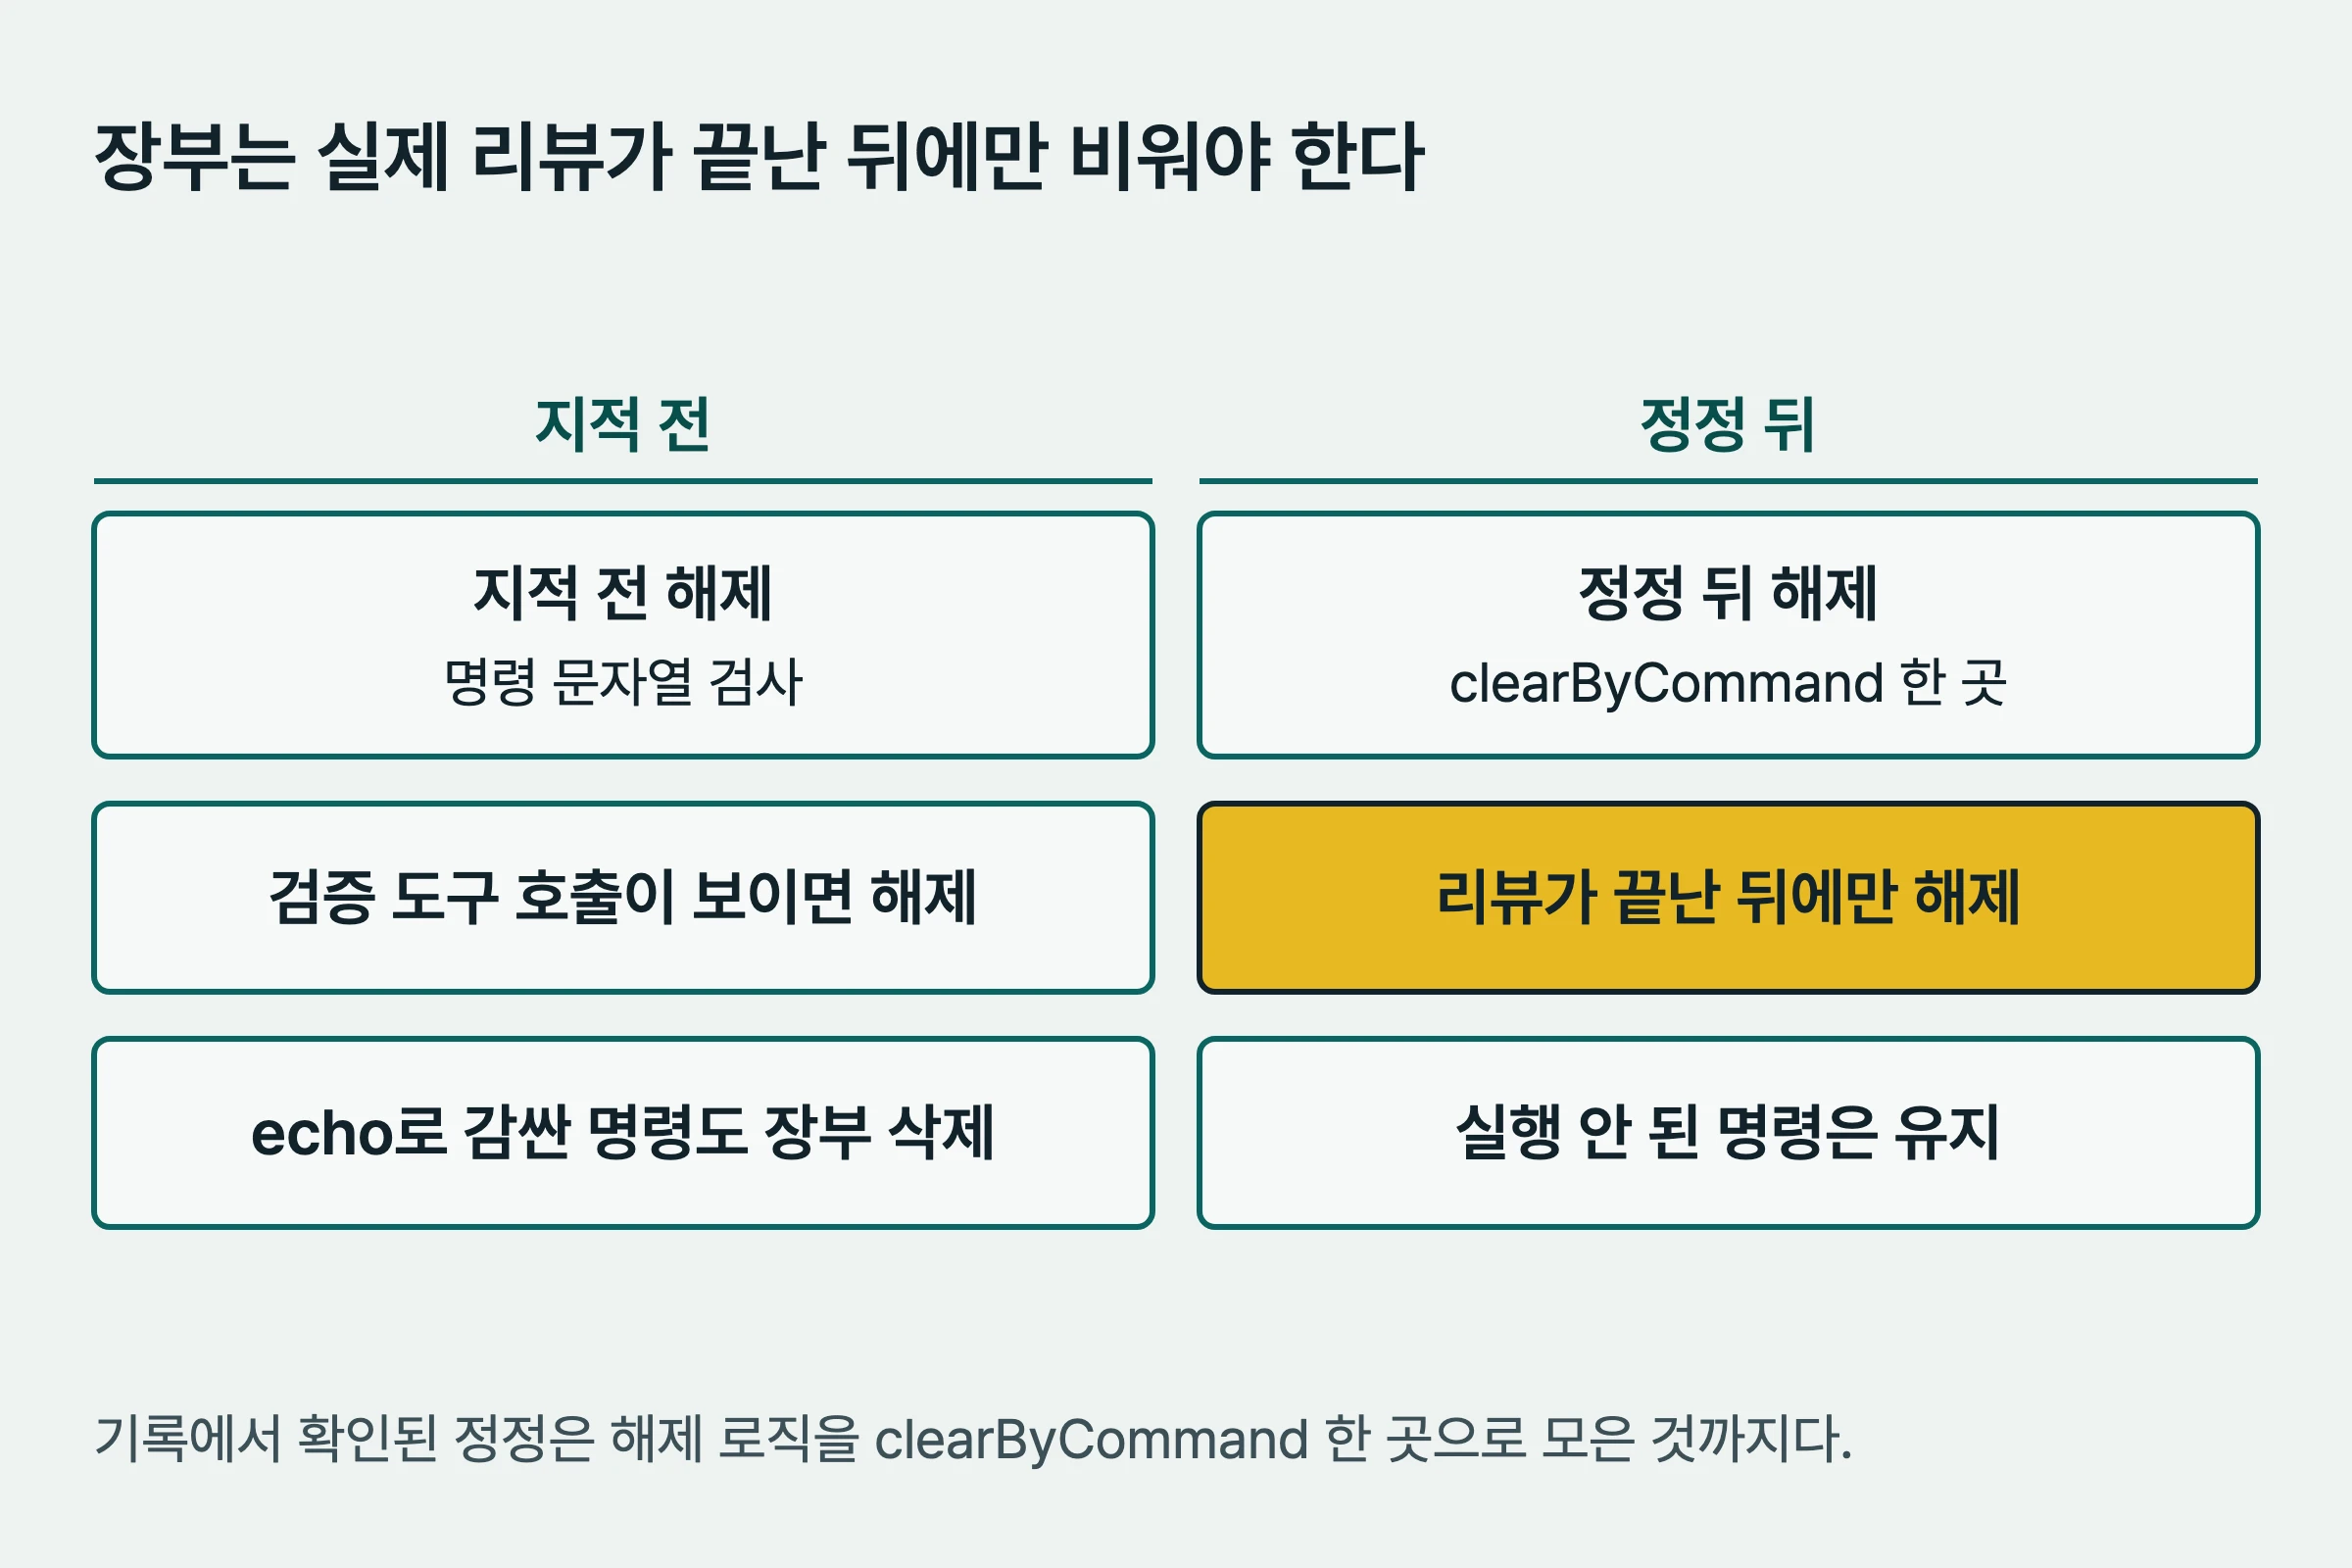
위 그림은 훅이 신뢰하는 줄과 장부를 지우는 시점을 한 흐름으로 정리한 것이다.
검증 단계마다 나온 결함과 정정
이번 작업은 계획 검증, 테스트 리뷰, 논리 리뷰, 문서 리뷰를 각각 한 번씩 거쳤고, 실패한 단계마다 정정은 한 번만 했다. 각 단계에서 나온 결함은 아래와 같다. 점수는 기록에 있는 값이다.
| 단계 | 결과 | 핵심 결함 | 정정 |
|---|---|---|---|
| 계획 검증 | 6/6/9/8/7 실패 | 차단 항목 C1, F1 | 계획을 한 번 정정하고 재검증하지 않음 |
| 테스트 리뷰 (보안 보완) | 커버리지 6, 차단 B1 실패 | 보완 시험이 부족 | 시험 보강 |
| 테스트 리뷰 | 6/6/6/8/7 실패 | 차단 B1, B2 | 정정 한 번 |
| 논리 리뷰 | 실패 | echo로 감싼 명령이 장부를 지움 | clearByCommand 한 곳 정정 |
| 문서 리뷰 | 1차 요청 결함, 2차 실패 | 중계 항목 충돌 | 해당 문서 두 줄 정정 |
계획 검증의 첫 시도는 HTTP 502로 검증 호출 전에 죽었다. 이어진 시도가 위 표의 결과다. 도구 장애와 계획 결함을 한 줄로 합치지 않으려고 따로 적는다. 검증 요청 파일 크기도 걸렸다. 요청이 219,233바이트로 사전 검사 한도 120,000바이트를 넘었는데, 줄여서 만든 패킷은 패킷 도구의 린트가 거부해서 전체 파일 패킷을 보냈다. 이 한도와 린트의 충돌은 별도 이슈로 남겼다. 리뷰어가 서로 다른 모델이어야 하는 이유는 검증자의 지적을 교차 확인한 기록에서 다룬 것과 이어진다.
이 단계에서 내가 얻은 것은 점수가 아니라 결함의 위치다. 위 표의 핵심 결함 가운데 보안에 직접 닿은 것은 표식 위조와 echo 우회 두 건이었고, 둘 다 사람이 코드를 쓸 때가 아니라 리뷰 단계에서 나왔다.
이어진 강화 작업에서도 같은 패턴이 반복됐다. 테스트 PR의 빨강 단언 실패 22개가 해당 매니페스트 항목 22개와 일치했고, 커버리지 전용 테스트 6개는 변이 m1~m6에서 실패했다. 논리 쪽의 Codex 리뷰는 6/6/6/8/8로 실패했고, 정정은 handoff.ts 58행 한 곳에서 이뤄졌다. 이 단계의 결과는 대상 테스트 78개 통과, bun 전체 898개 통과, 셸 89개 통과, 타입 검사와 린트 통과다.
이 강화 실행에서는 플러그인 버전이 0.5.24에서 0.5.25로 올랐고, 활성화 전후 평가 결과는 같았다. 활성화 뒤 실제 세션에서 주입과 검증 대기 표식이 동작하는 것을 다시 확인했다.
열린 채 병합한 것과 남은 한계
첫 인계 훅은 이슈 두 개를 연 채로 병합하고 활성화했다. 하나는 따로 띄워 실행한 리뷰가 시작되는 시점에 검증 대기 장부가 지워진다는 문제다. 리뷰가 끝나기 전에 장부가 비므로 “상대 리뷰가 끝난 뒤에만 해제”라는 조건과 어긋난다. 다른 하나는 분기해서 만든 작성 에이전트에는 GPT 결정 거부가 적용되지 않는다는 보안 관련 문제다.
그래프의 결정 메모는 실제 사고 경로, 곧 중계 누락과 GPT 아래의 범용 에이전트, 리뷰 미실행이 이 병합 시점의 방어로 덮인다고 적었다. 나는 이 메모를 열린 이슈가 사라졌다는 뜻으로 읽지 않는다. 덮인다는 판단은 기록의 주장이며, 두 이슈가 가리키는 틈은 병합 시점에 남아 있었다. 후속 기록은 이 이슈들을 닫는 PR로 강화 작업의 논리 PR을 연결했고, 별도의 보안 관련 P2 하나는 새 이슈로 열렸다. 이 글은 그 연결 기록까지만 옮겼고 이슈의 현재 상태는 다시 확인하지 않았다.
활성화 기록에서 한 가지 더 읽을 점이 있다. 작업을 진행한 메인 세션이 아직 이전 버전 훅으로 돌고 있었기 때문에, 새 훅이 실제로 적용됐는지는 세션 안의 자기 결정이 아니라 활성화 뒤 따로 돌린 프로브로 확인했다. 프로브는 자식 프롬프트에 작성자 벤더 줄이 실리는지와 결과에 검증 대기 표식이 남는지를 봤다. 훅을 고친 사람이 자기 세션의 동작을 증거로 삼으면 옛 훅의 출력을 새 훅의 증거로 착각할 수 있다.
남은 한계를 사실, 추정, 권장으로 나눠 적는다.
- 사실: GPT 결정 거부는 단위 테스트만 근거이고 실제 세션 프로브는 없다.
- 사실: 작업을 진행한 메인 세션은 플러그인 0.5.20의 훅으로 돌았다. 자기 결정은 재시작 전까지 옛 훅에서 나왔다.
- 추정: 해제 로직을 한 함수로 모은 것이
echo우회를 막는 데 충분한지는 기록된 리뷰 결과 밖에서 검증하지 않았다. - 권장: 장부를 지우는 신호는 명령 문자열이 아니라 실행 결과를 기준으로 삼는 편이 안전하다. 이 글의 기록은 그렇게 구현했다고 말하지 않는다.
이 사례에서 내가 가져간 점검 목록은 세 가지다. 훅이 넣은 표식과 모델이 쓴 같은 모양의 문자열을 구별하는가. 장부를 지우는 조건이 실행 결과가 아니라 문자열 포함 여부에 기대고 있지 않은가. 병합 시점에 열려 있는 이슈가 방어하려던 사고 경로를 실제로 덮는가. 권한 판단을 어디서 내려야 하는지는 Claude Code 권한 게이트에서 다룬 문제와 같은 줄기에 있다.
자주 묻는 질문
모델이 쓴 프롬프트의 표식 줄은 왜 위험한가?
훅이 넣은 줄과 모양이 같아서 구별되지 않으면 모델이 작성 레인의 거부 검사를 건너뛰거나 검증 대기 항목을 지우게 만들 수 있다. 리뷰가 P2 보안 지적으로 이 경로를 짚었고, 통과 범위를 검증자 유형과 이미 실행된 결정의 코디네이터로 좁혔다.
echo로 감싼 명령이 어떻게 장부를 지울 수 있었나?
훅이 Bash 명령 문자열에 리뷰 도구 호출이 들어 있는지만 보고 리뷰가 시작됐다고 판단했기 때문이다. echo는 그 문장을 출력만 하고 실행하지 않지만 문자열 검사에서는 같게 보인다. 정정은 해제 로직을 한 곳으로 모으는 것이었다.
이 수정으로 모든 우회가 막혔는가?
그렇게 말할 수 없다. 첫 병합 때 따로 실행한 리뷰가 시작 시점에 장부를 지우는 문제와, 분기 생성 에이전트에 GPT 결정 거부가 적용되지 않는 문제를 이슈로 열어 둔 채 병합했다. 후속 강화 작업이 이 이슈들을 닫는 PR로 연결됐지만, 그 뒤에도 보안 관련 P2 하나가 새 이슈로 열렸고 현재 상태는 확인하지 않았다.
아직 댓글이 없습니다.