기본 이름이 '계정 수 + 1'이라 Codex 구독 6이 세 개 생겼다: 가장 작은 빈 번호와 한 잠금 수정
삭제나 롤백 뒤 계정 수 + 1로 기본 이름을 만들면 같은 번호가 다시 나온다. 기록에 남은 수정과 합성 예시 재현으로 빈 번호 선택, 한 잠금 처리, 멱등 재번호를 정리한다.
계정을 추가할 때 "Codex 구독 6" 같은 기본 이름을 자동으로 붙이는 프로그램을 만들고 있다면, 번호를 "지금 계정 수 + 1"로 계산하는 부분을 의심해 볼 만하다. 내가 쓰는 개인 라우터 도구에서 정확히 그 계산 때문에 같은 이름 "Codex 구독 6"이 계정 세 개에 붙었다. 원인은 삭제나 중복 롤백 뒤에도 계정 수가 번호와 어긋난다는 점이었고, 고친 방법은 비어 있는 가장 작은 번호를 고르고 그 번호를 저장할 때까지 같은 잠금을 쥐는 것이었다. 이 글은 2026-11-05에 끝난 수정의 기록과, 그 구조를 내가 따로 만든 최소 예시로 다시 돌려 본 결과를 나눠서 다룬다. 이 글은 작성자의 작업 기록을 바탕으로 Claude 모델이 초안을 작성했다.
기록에 남은 사고와 수정
대상은 여러 AI 구독 계정의 사용량을 한곳에서 라우팅하는 내 개인 도구다. 계정을 직접 지정한 이름 없이 추가하면 도구가 "Codex 구독 N" 형태의 기본 이름을 붙인다. 실행 기록에 남은 문제는 이 이름이 겹친 것이다. "Codex 구독 6"이 세 개 생겼다. 기록이 짚은 원인은 한 줄이다. 기본 이름 함수가 계정 수에 1을 더한 값을 번호로 썼고, 계정을 삭제하거나 중복 때문에 롤백한 뒤에는 그 번호를 다시 내줬다.
고침은 세 부분으로 기록돼 있다.
- 비어 있는 가장 작은 번호를 고른다. 고르는 일과 저장하는 일을 저장소 하나의 잠금 안에서 끝낸다.
- 허브를 만들 때 겹친 기본 형식 이름만 우선순위에 따라 다시 번호를 매긴다. 다시 실행해도 결과가 같고 스키마는 바꾸지 않는다.
- 이름만 바꾸는
Store::rename_account를 추가한다.
같은 기록에서 확인되는 실행 결과를 표로 모았다.
| 항목 | 기록된 값 |
|---|---|
| 겹친 이름 | "Codex 구독 6"이 세 개 |
| 계획 검증 | 1회 실패(RED 컴파일, 직접 입력 이름, 동시성 세 지적). 한 번 정정, 재검증 없음 |
| RED 단계 | 시험 15개 중 12개가 단언 실패 |
| GREEN 단계 | 시험 15개 모두 통과 |
| 시험 리뷰 | 1회 실패(커버리지 6). 정정 한 번 |
| 논리 리뷰 | 1~2차는 자료 누락으로 검토되지 않음. 3차 통과(9/8/8/9/8) |
| 전체 검사 | Rust 전체 검사 통과, pytest 474개 통과 |
수정은 develop에 병합됐고 관련 이슈는 닫혔다. 이후 main도 승격됐다. 이 글에서 "기록"이라고 부르는 것은 이 실행의 종료 기록이며, 값은 실행 기록에서 옮긴 것이지 내가 이번에 다시 돌려 확인한 것이 아니다.
계정 수 + 1이 틀리는 순간
"계정 수 + 1"은 번호가 1부터 빈틈없이 이어진다는 가정에서 나온 계산이다. 계정이 늘기만 하면 맞다. 중간 계정이 하나라도 사라지면 가정이 깨진다. 아래는 기록의 구조를 따라 내가 만든 합성 예시다. 실제 계정 데이터가 아니고, 2026-11-09에 Python으로 실행했다.
def label_count_plus_one(labels):
    return f"Codex 구독 {len(labels) + 1}"

def label_smallest_free(labels):
    used = {int(m.group(1)) for l in labels
            if (m := re.fullmatch(r"Codex 구독 (\d+)", l))}
    n = 1
    while n in used:
        n += 1
    return f"Codex 구독 {n}"
계정 여섯 개를 만들고 "Codex 구독 2"를 삭제한 뒤 두 개를 더 추가했다.
count+1       ['Codex 구독 1', 'Codex 구독 3', 'Codex 구독 4', 'Codex 구독 5',
               'Codex 구독 6', 'Codex 구독 6', 'Codex 구독 7']
  중복: ['Codex 구독 6']
smallest-free ['Codex 구독 1', 'Codex 구독 3', 'Codex 구독 4', 'Codex 구독 5',
               'Codex 구독 6', 'Codex 구독 2', 'Codex 구독 7']
  중복: []
계정이 다섯 개로 줄었을 때 계정 수 + 1은 6을 낸다. 이미 6번이 있으니 같은 이름이 둘이 된다. 가장 작은 빈 번호를 고르면 비어 있던 2번이 채워지고 중복은 없다.
번호는 개수에서 계산하는 값이 아니라, 지금 쓰이고 있는 번호의 집합에서 찾는 값이다. 개수는 집합에 빈틈이 없을 때만 번호와 같다.
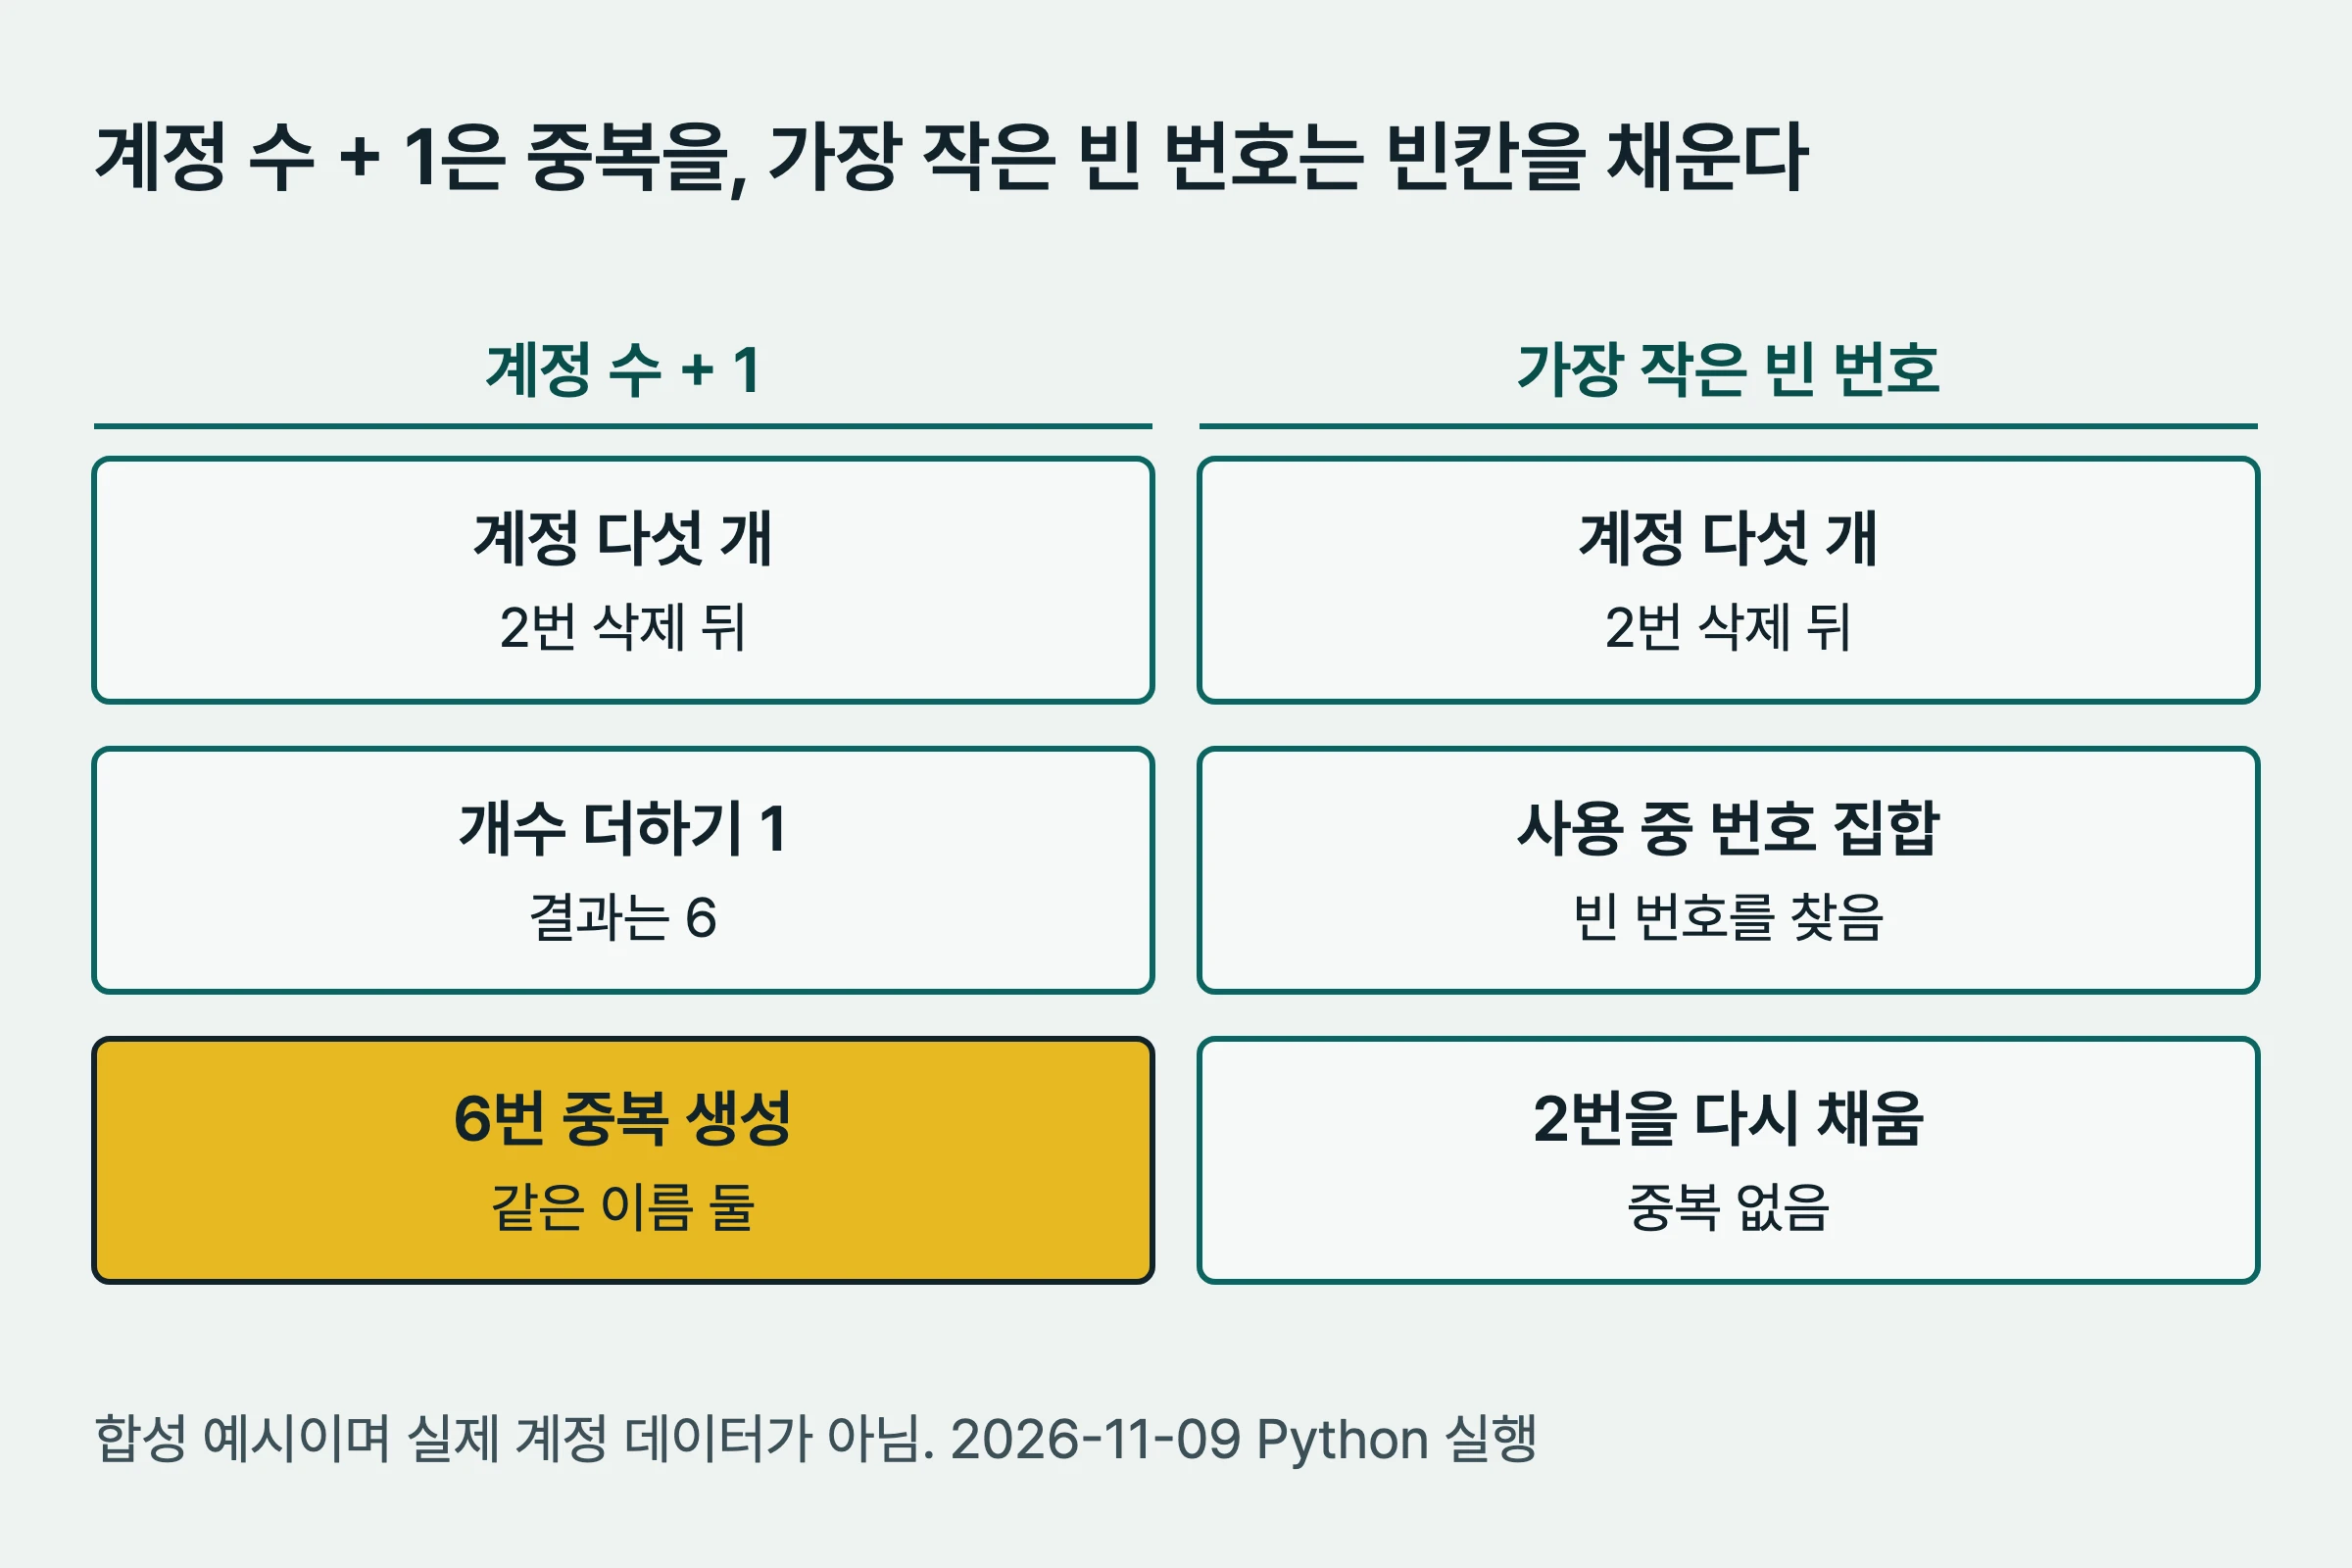
위 그림은 같은 삭제 상황에서 두 방식이 내는 번호를 나란히 놓은 것이다.
기록의 "세 개"가 어떤 삭제와 추가 순서로 생겼는지는 실행 기록에 없다. 내 예시는 중복이 하나 생기는 가장 짧은 순서일 뿐, 실제 사고를 그대로 복원한 것이 아니다.
번호를 다시 내주는 방식은 데이터베이스에서도 설계 선택으로 다룬다. PostgreSQL 문서는 시퀀스가 트랜잭션이 롤백돼도 값을 되돌리지 않아 빈 칸이 생긴다고 설명하고, "gapless" 시퀀스를 얻는 데에는 쓸 수 없다고 적는다. SQLite 문서는 AUTOINCREMENT 없이는 현재 최대값보다 1 큰 미사용 정수를 고르며, AUTOINCREMENT를 붙이면 삭제된 행의 번호를 다시 쓰지 않는다고 설명한다. 두 문서가 보여 주는 것은 같은 선택지다. 번호를 한 번만 쓰고 빈 칸을 허용할지, 빈 번호를 다시 쓸지 정해야 한다. 내 도구의 기본 이름은 사람이 읽는 라벨이라 빈 번호를 다시 쓰는 쪽이 자연스럽다. 그 대신 "지금 쓰이지 않는 번호"를 정확히 찾아야 하고, 이 점이 다음 절의 잠금 문제로 이어진다.
고르기와 저장 사이에서 잠금이 끊기면
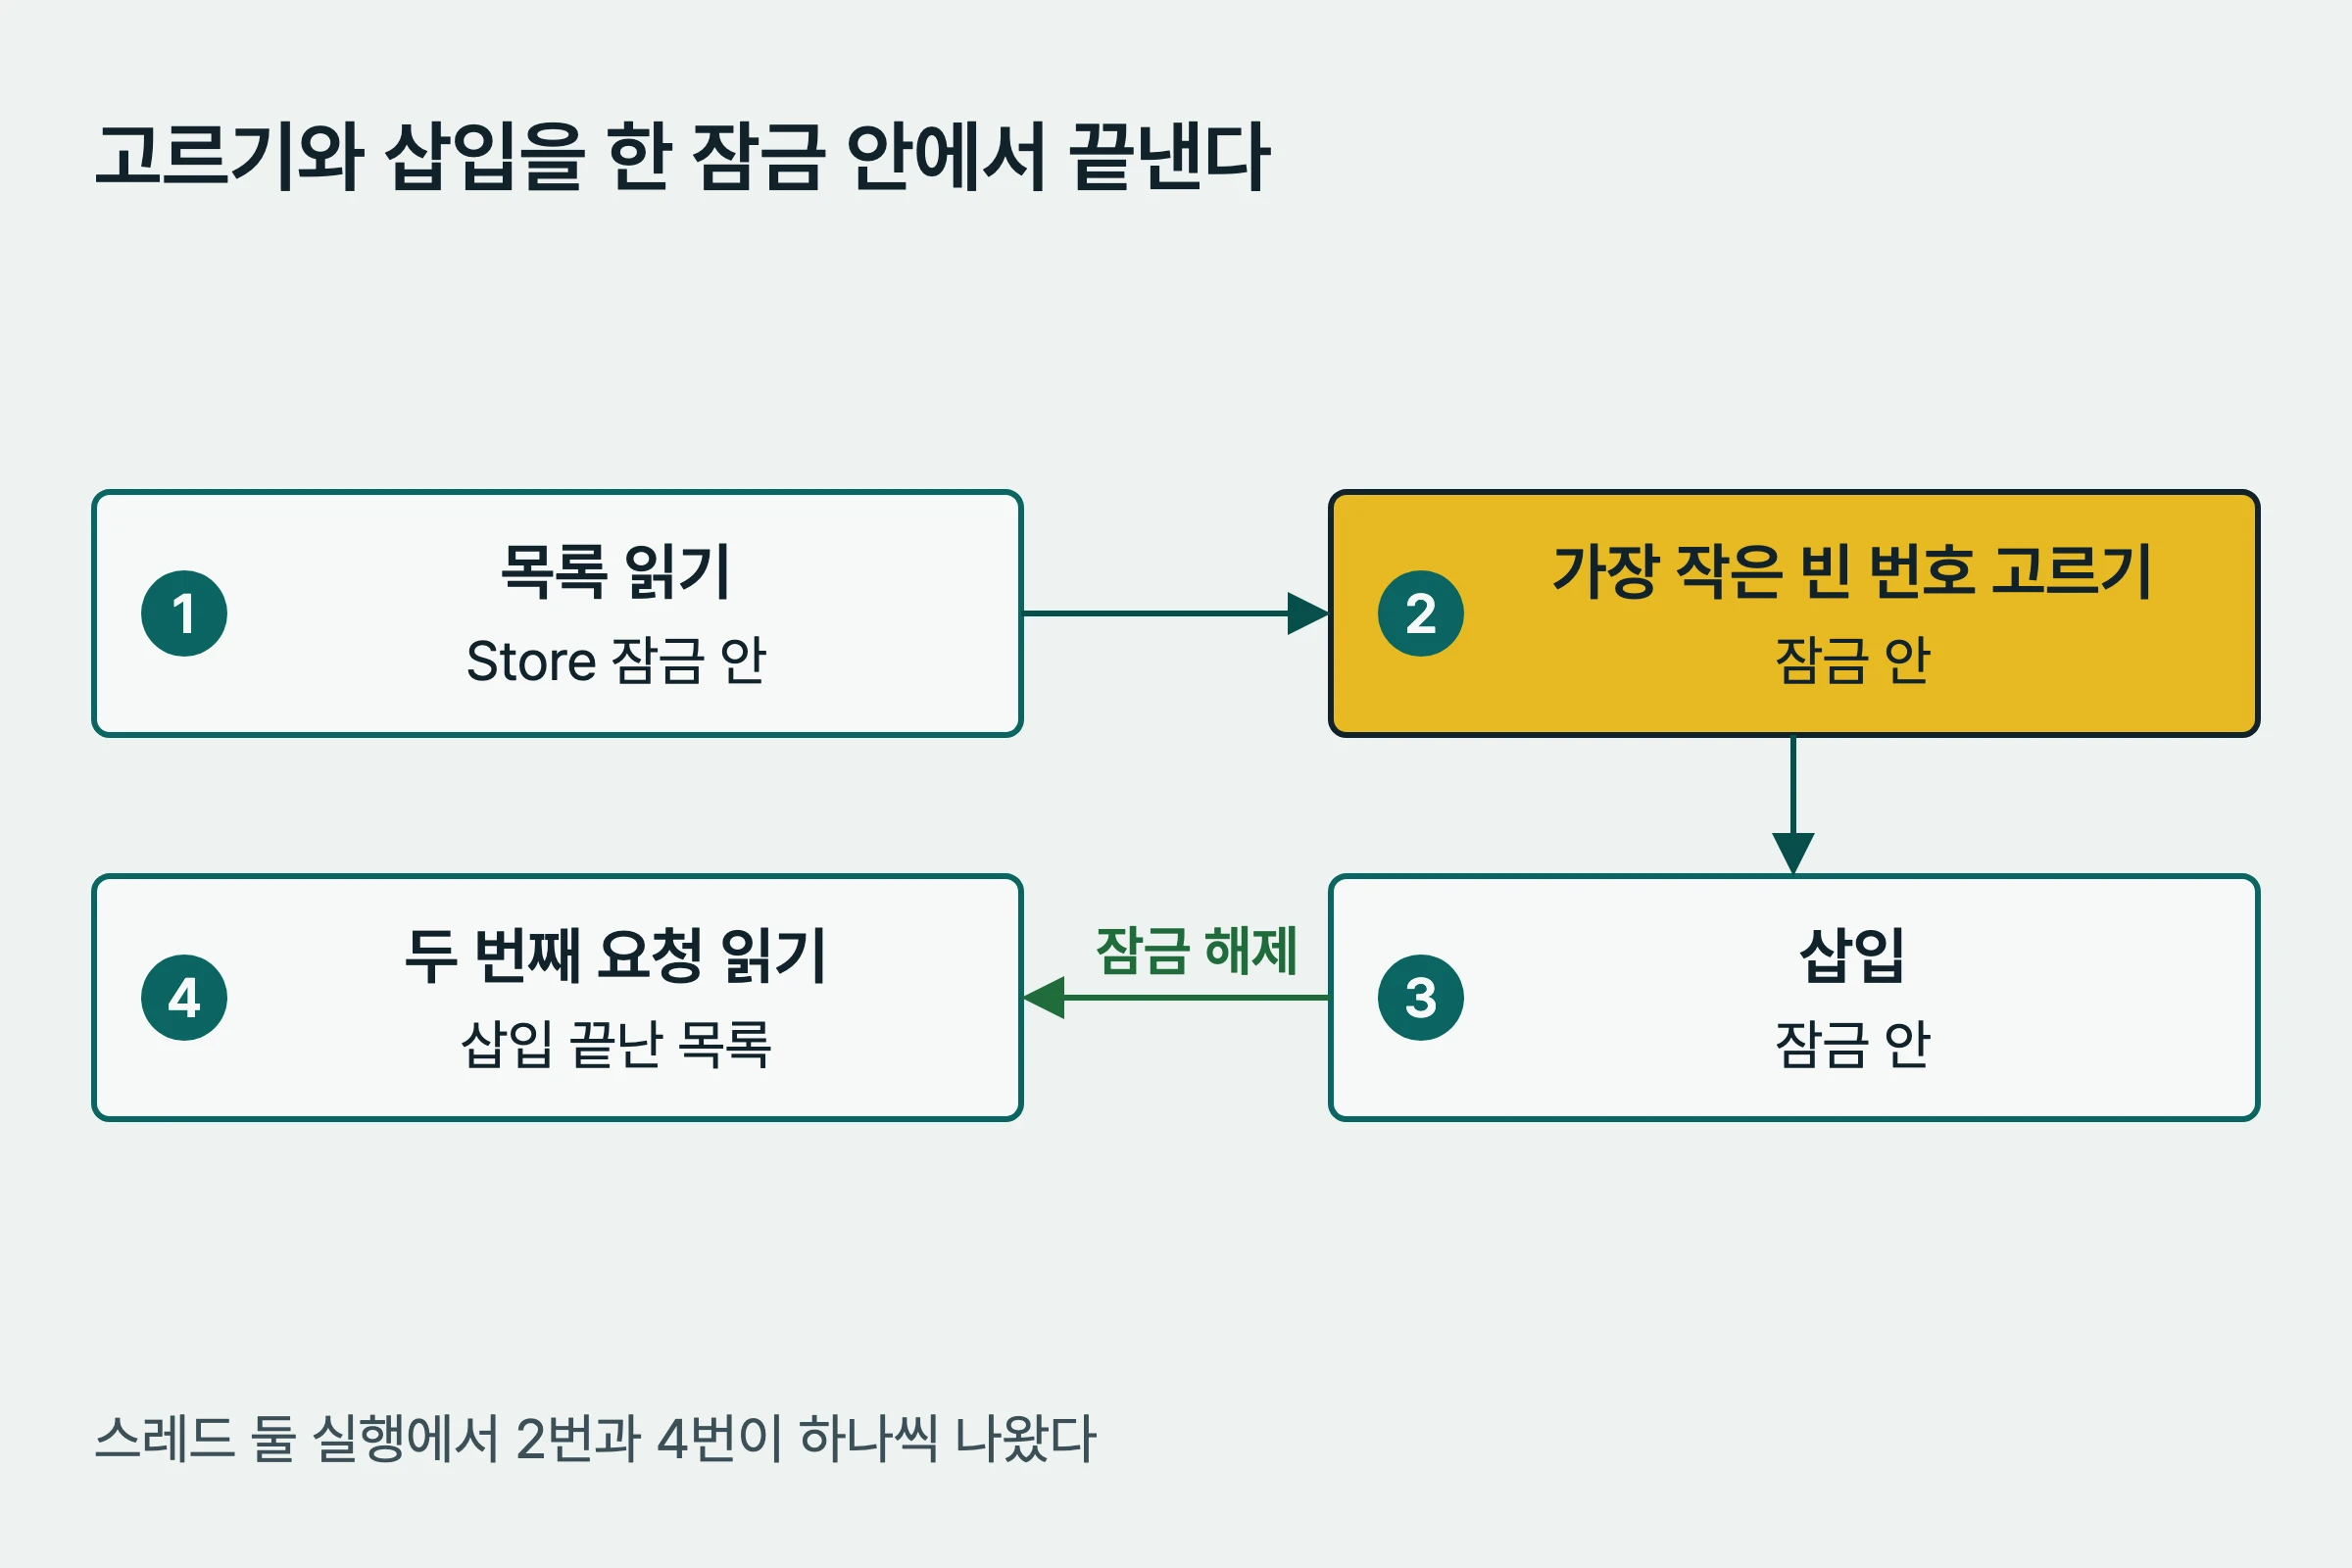
가장 작은 빈 번호를 골라도 부족한 경우가 있다. 두 요청이 같은 목록을 보고 같은 번호를 고르면 다시 겹친다. 기록이 고르는 일과 삽입을 "한 번의 Store 잠금 안"에서 처리했다고 적은 이유가 이 경우다. 계획 검증이 세 번째로 지적한 항목도 동시성이었다. 같은 상황을 예시로 만들었다.
store = ["Codex 구독 1", "Codex 구독 3"]
pick_a = smallest_free(store)   # 요청 A가 번호를 고른다
pick_b = smallest_free(store)   # 요청 B도 같은 목록을 본다
store.append(pick_a); store.append(pick_b)

# 잠금 분리: ['Codex 구독 1', 'Codex 구독 3', 'Codex 구독 2', 'Codex 구독 2']
고르는 함수는 맞는데도 결과가 틀렸다. 번호를 정하는 시점과 저장하는 시점이 떨어져 있어서, 그 사이에 다른 요청이 같은 판단을 내렸기 때문이다. 고르기와 넣기를 한 잠금 안에 두면 두 번째 요청은 첫 번째 요청의 삽입이 끝난 목록을 본다.
with lock:
    store.append(smallest_free(store))

# 한 잠금: ['Codex 구독 1', 'Codex 구독 2', 'Codex 구독 3', 'Codex 구독 4']
스레드 둘로 실행한 결과 2번과 4번이 하나씩 나왔다. 어느 스레드가 어느 번호를 받는지는 실행마다 달라질 수 있다. 하지만 이 예시에서는 두 번호가 서로 다르다는 성질은 잠금이 보장한다. 아래 그림은 잠금 안에서 읽기, 고르기, 삽입이 이어지는 순서를 보여 준다.
이미 겹친 이름을 읽을 때
수정 전에 만들어진 데이터에는 이미 겹친 이름이 들어 있다. 새로 만드는 번호만 고치면 이 이름들은 그대로 남는다. 기록은 허브를 만들 때 겹친 기본 형식 이름만 우선순위에 따라 다시 번호를 매기고, 결과가 멱등이며 스키마를 바꾸지 않는다고 적는다. 사용자가 직접 지은 이름은 건드리지 않는다는 뜻이다. 계획 검증의 두 번째 지적이 "직접 입력한 이름"이었던 것과 맞닿는다.
우선순위의 정확한 규칙은 기록에 없다. 아래 예시는 목록에서 앞에 있는 쪽을 먼저로 보는 단순한 규칙으로 내가 만든 것이다.
dup = ["Codex 구독 1", "Codex 구독 6", "Codex 구독 6",
       "Codex 구독 6", "내가 붙인 이름"]

재번호: ['Codex 구독 1', 'Codex 구독 6', 'Codex 구독 2',
         'Codex 구독 3', '내가 붙인 이름']
멱등: True
첫 번째 "Codex 구독 6"은 그대로 두고, 나머지 둘은 빈 번호 2와 3으로 옮겼다. 직접 지은 이름은 바뀌지 않았고, 한 번 더 적용해도 결과가 같았다. 멱등성이 필요한 이유는 허브를 만들 때마다 이 과정이 다시 돈다는 점이다. 결과가 달라진다면 실행할 때마다 이름이 바뀌어 사용자가 혼란을 겪는다.
정리하면 기본 이름 문제는 서로 다른 세 지점에서 막아야 한다.
| 방식 | 삭제 뒤 추가 | 동시에 두 요청 | 이미 겹친 데이터 |
|---|---|---|---|
| 계정 수 + 1 | 번호 중복 발생 | 번호 중복 발생 | 그대로 남음 |
| 가장 작은 빈 번호(잠금 분리) | 중복 없음 | 번호 중복 발생 | 그대로 남음 |
| 가장 작은 빈 번호(고르기와 저장을 한 잠금) | 중복 없음 | 중복 없음 | 읽을 때 재번호로 정리 |
비슷한 이름 생성기를 점검하는 목록
이 수정에서 뽑은 점검 항목이다. 첫 세 항목은 기록의 수정 내용에서, 뒤 두 항목은 위 합성 예시에서 나왔다. 내가 다른 코드에서 이 목록을 실제로 적용해 본 기록은 없으므로, 권장 절차로만 읽어 주기 바란다.
- 번호를
len(items) + 1이나 마지막 번호 + 1로 계산하는 곳이 있는지 찾는다. 삭제 경로가 하나라도 있으면 그 계산은 틀릴 수 있다. - 번호를 고른 시점과 저장한 시점 사이에 잠금이 풀리는 구간이 있는지 본다. 목록을 읽는 함수와 쓰는 함수가 따로 잠금을 잡으면 그 사이가 구간이다.
- 이미 저장된 데이터에 같은 이름이 있을 수 있다고 가정하고, 읽을 때 정리하는 경로를 둔다. 정리는 같은 입력에 같은 결과를 내야 한다.
- 사용자가 직접 지은 이름은 기본 형식과 구별해 건드리지 않는다. 형식이 같아 보이는 직접 입력은 별도 시험으로 확인한다.
- 시험은 삭제 뒤 추가, 동시 추가, 이미 겹친 데이터의 세 경우를 각각 따로 만든다. 한 시험이 세 경우를 한꺼번에 덮으면 어느 지점이 깨졌는지 알기 어렵다.
이 수정을 무엇으로 확인했나
기록에서 확인되는 증거는 두 가지다. 첫째는 의도된 RED였다. 수정 전 코드에 시험 15개를 돌렸을 때 12개가 단언에서 실패했고, 수정 뒤에는 15개가 모두 통과했다. 15개 중 3개는 수정 전에도 통과했다는 뜻이다. 어떤 시험이 그 세 개인지는 기록에 없다. 둘째는 다른 검증자의 지적이다. 시험 리뷰는 커버리지 6점으로 한 번 실패했고, 정정은 한 번이다. 논리 리뷰는 앞의 두 차례가 요청 자료 누락으로 검토되지 못했고, 이 점을 편차로 남겼다. 세 번째 리뷰가 9/8/8/9/8로 통과했다.
이 순서에서 배울 점은 "시험이 먼저 실패했다"는 사실의 무게다. 수정 뒤의 통과만 있었다면 시험이 문제를 실제로 겨냥하는지 알 수 없다. 15개 중 12개가 수정 전에 실패했으니, 그 12개는 적어도 이 결함의 유무에 반응한다. 나머지 3개는 이 기록만으로는 "기존 동작 보존" 같은 별도 목적이라고 추정만 할 수 있고 확인하지는 못했다.
다른 실행에서 시험 설계와 기준선을 다룬 기록도 있다. 시험을 먼저 실패시키고 나서 고치는 절차를 다룬 기록은 읽기 전용 RED 시험 기록에, 같은 라우터가 오래된 사용량 때문에 계정을 잘못 거절한 사건은 사용량 재조회 수정 기록에 있다. 다른 글은 프로그래밍 카테고리에서 볼 수 있다.
기록이 말하지 않는 것
- "세 개"가 생긴 삭제·추가 순서와 실제 계정 구성은 이 글에서 다루지 않았다. 실행 기록에는 실데이터 표본 파일이 있다고만 적혀 있고, 나는 그 파일을 열지 않았다.
- 수정 코드는 Rust이며 이 글의 예시는 Python으로 만든 합성 코드다. 구조는 같아도 실제 구현과 동일하지 않다.
- 우선순위가 정확히 무엇인지, 시험 15개의 개별 내용, 수정 전에도 통과한 3개의 정체는 기록에 없다.
- Rust 전체 검사와 pytest 474개 통과, 리뷰 점수는 기록에서 옮긴 값이다. 이번 글을 쓰며 다시 실행하지 않았다.
- 번호를 다시 내주는 방식의 단점은 이 글에서 재현하지 않았다. 삭제한 계정의 이름을 로그에서 보고 그 번호가 다른 계정을 가리킨다고 읽을 가능성이 있다. 이 문장은 추정이다.
이 사고에서 확인한 것은 하나다. 라벨 번호가 개수에서 나온다고 가정한 코드는 삭제가 하나만 있어도 무너지고, 번호를 고르는 코드는 저장까지 같은 잠금 안에 있어야 동시 요청에서도 맞는다.
자주 묻는 질문
왜 계정 수 + 1로는 안 되나요?
번호가 1부터 빈틈없이 이어진다는 가정이 필요하기 때문입니다. 계정 하나만 삭제돼도 개수와 가장 큰 번호가 어긋나서 이미 쓰는 번호를 다시 내줍니다.
가장 작은 빈 번호만 고르면 충분한가요?
충분하지 않습니다. 번호를 고르고 저장하는 사이에 다른 요청이 같은 목록을 보면 같은 번호를 고릅니다. 고르기와 저장을 한 잠금 안에서 끝내야 합니다.
이미 겹친 이름은 어떻게 정리하나요?
기록에 따르면 허브를 만들 때 겹친 기본 형식 이름만 우선순위에 따라 다시 번호를 매깁니다. 직접 지은 이름은 건드리지 않고, 다시 실행해도 결과가 같습니다.
번호를 다시 쓰지 않는 방식이 더 안전하지 않나요?
PostgreSQL 시퀀스나 SQLite AUTOINCREMENT처럼 번호를 한 번만 쓰면 중복은 피하지만 빈 번호가 남습니다. 사람이 읽는 기본 이름이라면 빈 번호를 다시 쓰는 쪽이 읽기 쉬워서 이 도구는 그쪽을 택했습니다.
참고한 자료
- PostgreSQL 문서: Sequence Manipulation Functions: 롤백돼도 되돌리지 않는 시퀀스와 "gapless" 불가 설명(조회 2026-11-09)
- SQLite Autoincrement: 최대값 + 1 선택과 AUTOINCREMENT의 번호 재사용 방지(조회 2026-11-09)
아직 댓글이 없습니다.