사이트맵은 정상인데 카테고리 20편 상한이 위험한 이유
발행한 글은 38편, 사이트맵(sitemap, 사이트의 URL 목록을 구글에 제출하는 파일)에 등록된 URL은 46개였다. 홈 1개, 정적 페이지 4개, 카테고리 페이지 3개, 글 38편을 더한 숫자다. 사이트맵만 열어 보면 흠잡을 데가 없었다. robots.txt도 정상이었고, 각 글에는 표준 URL(canonical, 같은 내용의 대표 주소를 검색엔진에 알려주는 태그)과 OG 태그, `Article`과 `BreadcrumbList` 구조화 데이터(JSON-LD)까지 다 박혀 있었다. 온페이지 SEO 체크리스트는 전부 초록불이었다.
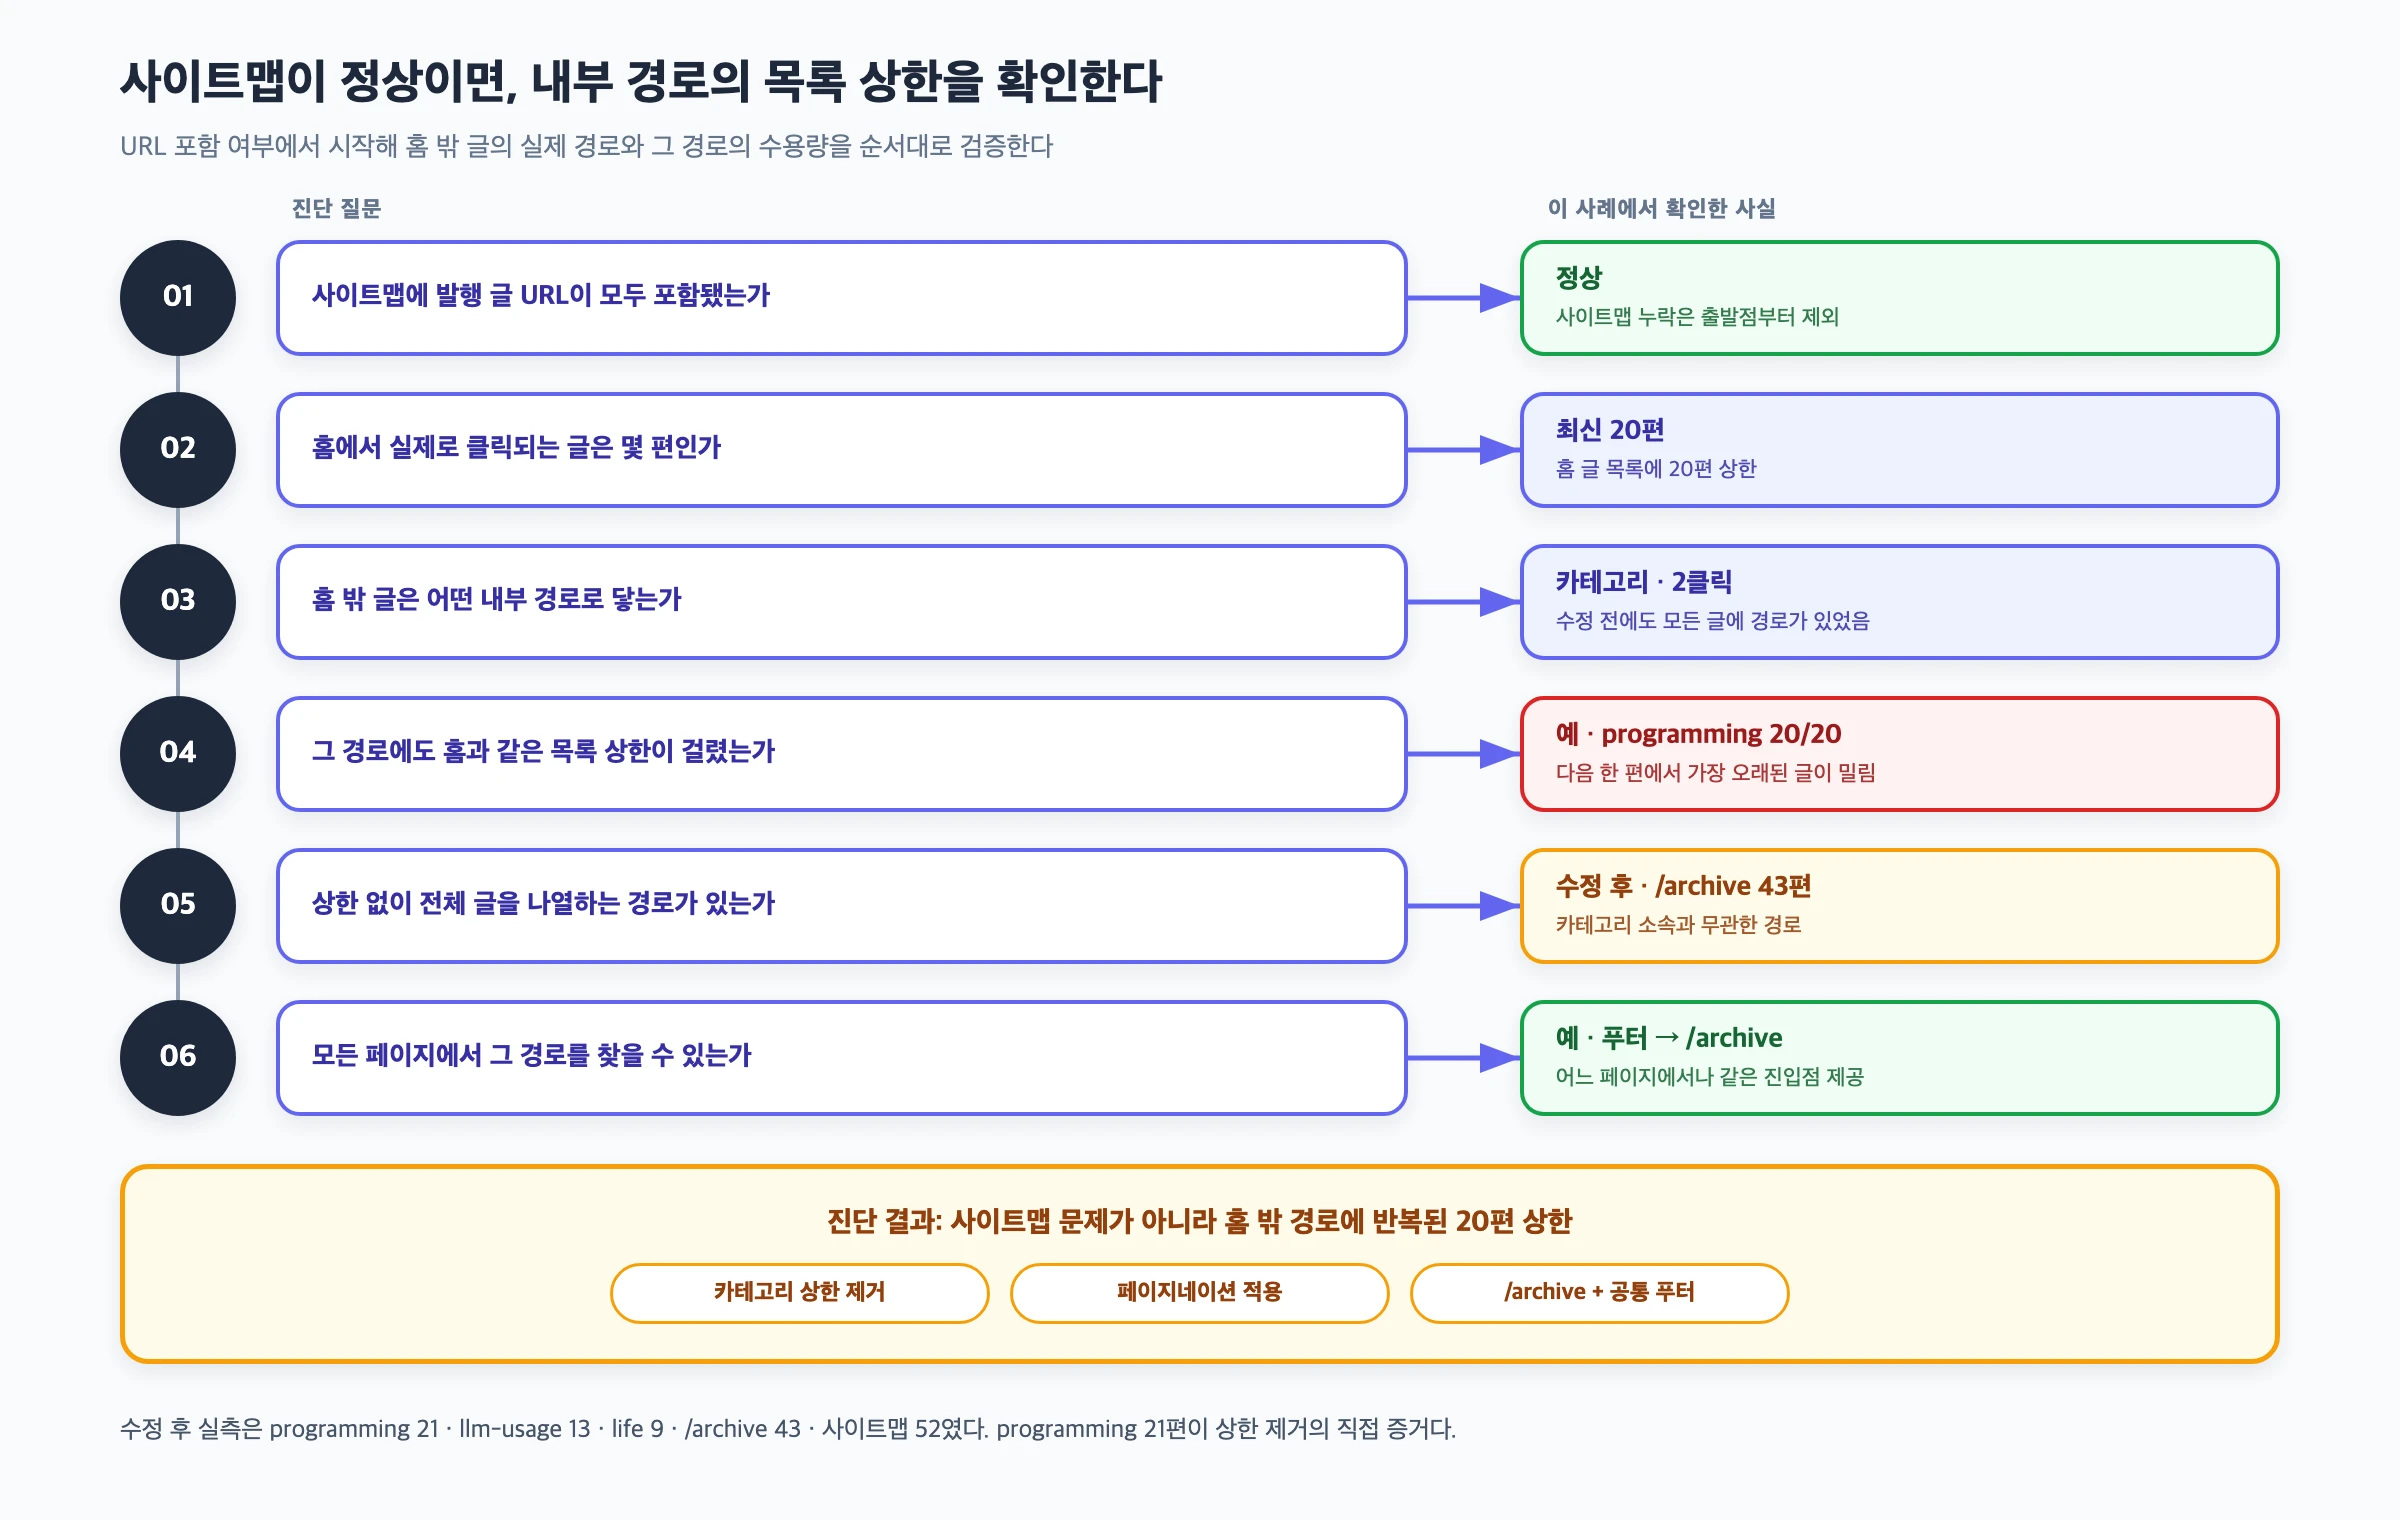
그런데 홈 화면을 다시 열어 세어 보니 최신 글 목록은 20편에서 끝났다. 나머지 18편은 홈에서 직접 갈 수 없었지만, 카테고리 페이지를 거치면 두 번의 클릭으로 닿았다. 당시 모든 글에는 내부 경로가 있었으므로 홈 목록과 사이트맵의 개수 차이 자체가 결함은 아니었다. 실제 문제는 그 다음에 확인한 카테고리 목록의 상한이었다.
증상: 홈과 카테고리에 같은 20편 상한이 걸려 있었다
문제를 처음 눈치챈 계기는 단순했다. 오래된 글 하나의 URL을 직접 입력해 들어가 봤는데 페이지 자체는 멀쩡했다. 렌더링도 되고 메타 태그도 다 채워져 있었다. 그 글로 가는 링크는 홈에서 직접 찾을 수 없었지만 카테고리 페이지에는 있었다. 사이트 이름으로 검색했을 때 개별 글이 좀처럼 보이지 않았다는 인상이 링크 구조를 들여다보게 한 계기였을 뿐, 색인 상태나 노출 변화를 측정한 결과는 아니었다.
홈 구조를 코드로 확인했다. 최신 20편을 최신순으로 나열하는 로직만 있고, 그 아래로 더 보기 버튼이나 페이지 번호를 넘기는 페이지네이션(pagination, 목록을 여러 쪽으로 나눠 다음 페이지로 넘어가게 하는 기능) 링크는 없었다. 홈이 최신 글 일부만 보여 주는 건 설계상 자연스러웠다. 홈에 없는 글을 카테고리가 빠짐없이 이어 주기만 하면, 오래된 글도 "홈 → 카테고리 → 글" 경로로 계속 닿을 수 있기 때문이다.
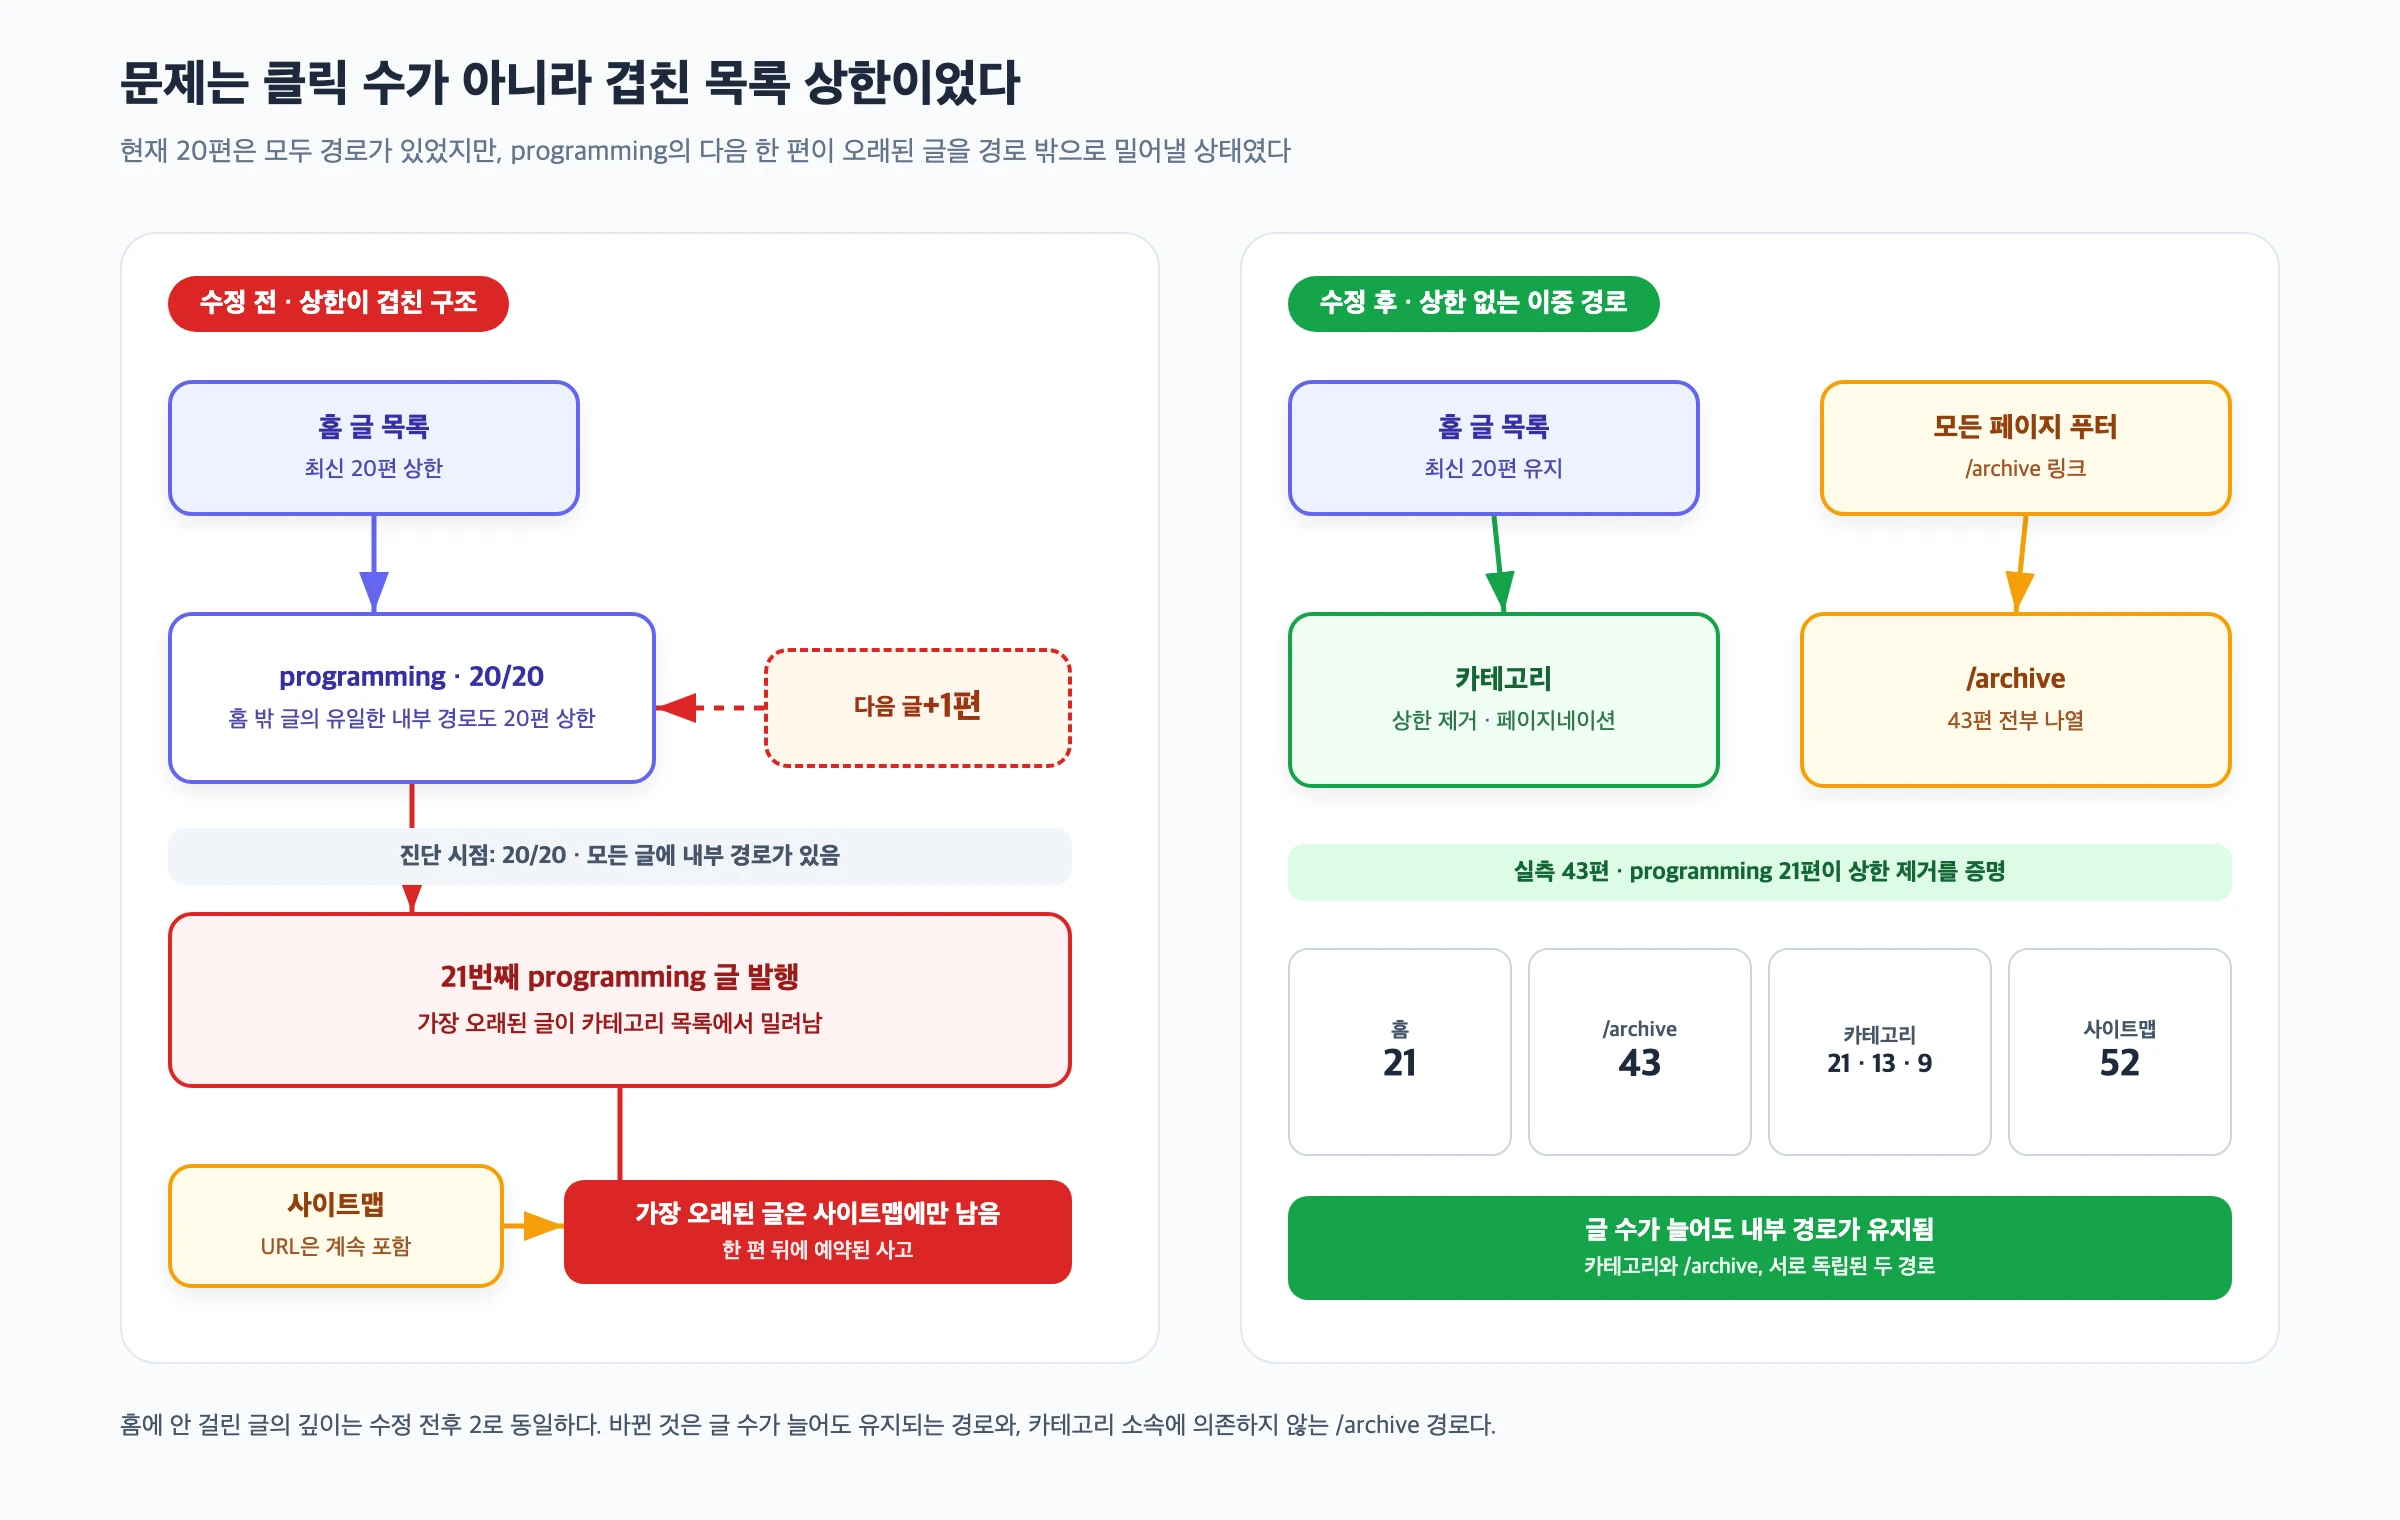
카테고리 구현을 열어 보자 판단이 달라졌다. 카테고리 목록에도 홈과 똑같은 20편 상한이 들어 있었다. 진단 당시 programming 카테고리는 정확히 20편이었다. 화면에는 20편이 모두 보였고 빠진 글도 없어서 겉으로는 정상처럼 보였다. 그러나 programming 글을 한 편 더 발행하는 순간 가장 오래된 글이 목록에서 밀려나도록 경계값에 닿아 있었다.
사고는 아직 나지 않았다. 그 시점의 가장 오래된 programming 글도 카테고리에서 클릭할 수 있었다. 다만 다음 글 한 편이 발행되면 그 글은 홈의 최신 목록에도, 20편에서 잘린 카테고리 목록에도 남지 않는다. 그때부터 내부 링크로 닿을 수 없고 사이트맵에만 남게 된다. 에러 로그나 빌드 실패 없이 한 편 뒤에 발생하도록 예약된 결함이었다.
흔한 오해: 사이트맵 제출이 발견을 보장한다는 착각
여기서 내가 오랫동안 갖고 있던 전제 하나를 짚어야 한다. "사이트맵에 올렸으니 구글이 알아서 찾아 읽는다"는 생각이다. 절반만 맞았다. 사이트맵은 이 URL들이 존재한다고 알리는 신호일 뿐, 크롤러(crawler, 웹 페이지를 자동으로 따라다니며 내용을 읽어 가는 프로그램)가 그 URL을 실제로 찾아가 읽겠다고 약속하는 문서가 아니다. Google Search Central의 사이트맵 안내 문서도 사이트맵이 색인을 보장하지 않는다고 명시한다.
크롤러가 새 페이지를 발견하는 경로는 크게 두 가지다. 사이트맵에 올라온 URL 목록, 그리고 이미 알고 있는 페이지에서 뻗어 나가는 내부 링크다. 사이트맵은 "이런 주소들이 있다"고 신고하는 명단에 가깝고, 내부 링크는 크롤러가 사이트 안에서 실제로 따라가는 경로다. 사이트맵에 URL이 있어도 크롤러의 방문이나 색인은 보장되지 않는다. 내부 링크 그래프가 끊기지 않았는지 별도로 확인해야 하는 이유다.
내가 겪은 범위에서는 이 둘의 차이를 직접 세어 보기 전까지 구분하지 못했다. 사이트맵 파일 하나를 잘 만들어 두면 발견 문제는 끝난 줄 알았다. 실제로 확인해야 했던 건 링크 그래프(link graph, 페이지들이 서로를 링크로 연결한 전체 구조)가 글 수 증가를 견디는지였다. 홈의 20편 상한은 카테고리 경로가 보완했지만, 카테고리까지 같은 상한을 가지면 그 보완 경로는 다음 글에서 사라질 수 있었다.
구글 검색 콘솔의 색인 보고서는 "발견됨(discovered)"과 "크롤됨(crawled)"을 구분한다. 발견됐다고 곧바로 크롤되는 게 아니라는 뜻을 그 구분 자체가 드러낸다. 사이트맵에 이름을 올리는 일과 내부 링크로 계속 닿을 수 있게 하는 일은 서로 대신할 수 있는 작업이 아니었다. 이번 점검도 사이트맵 통과 여부가 아니라 발행 수가 상한을 넘은 뒤 링크가 유지되는지를 기준으로 다시 봐야 했다.
진단: 사고는 다음 글 한 편 뒤에 예약돼 있었다
일단 화면을 넘겨짚지 않고 실제로 세어 보기로 했다. 홈이 몇 편을 링크하는지, 카테고리 페이지가 몇 편을 링크하는지, 각 글 상세 페이지에 다른 글로 가는 링크가 있는지를 하나씩 확인했다. 결과는 다음과 같았다.
- 홈: 최신 20편만 링크, 페이지네이션 링크 0개.
- programming 카테고리 페이지: 당시 글 20편을 모두 링크했지만 조회 상한도 20편.
- 나머지 글: 홈에서 카테고리를 거쳐 두 번의 클릭으로 모두 도달 가능.
- 다음 programming 글: 발행 순간 가장 오래된 한 편이 카테고리 목록에서 밀릴 예정.
크롤 깊이(crawl depth, 홈에서 몇 번의 링크 클릭을 거쳐야 그 페이지에 도달하는지 세는 단위)를 따로 계산하자 수정 전 상태가 선명해졌다. 홈에 직접 링크된 최신 20편은 깊이 1, 나머지는 "홈 → 카테고리 → 글"로 깊이 2였다. 뒤에 `/archive`를 추가해도 홈에 없는 글은 "홈 → /archive → 글"로 깊이 2다. 바뀐 것은 글의 클릭 수가 아니라 20편을 넘겨도 링크가 사라지지 않는다는 점과 카테고리 하나에만 기대지 않아도 된다는 점이었다.
경계값 결함은 현재 화면만 눈으로 봐서는 드러나지 않았다. 목록에 나온 수와 실제 발행 수를 비교하고, 조회 코드의 제한값과 다음 페이지 링크를 함께 확인해야 했다. 이번에는 다음 순서로 점검했다.
| 확인 항목 | 확인 방법 | 위험 신호 |
|---|---|---|
| 사이트맵 URL 수 | sitemap.xml을 열어 URL 개수를 센다 | 발행 글 수와 맞는지만 확인하고 끝내는 경우 |
| 홈 최신 목록 상한 | 홈 화면의 글 링크 수와 조회 제한값을 확인한다 | 상한은 있지만 다른 전체 경로가 없음 |
| 카테고리별 글 수 | 발행 글 수와 카테고리 화면의 링크 수를 비교한다 | 화면 수가 20 같은 값에서 멈춤 |
| 카테고리 페이지네이션 | '다음' 또는 페이지 번호로 20편 뒤를 열 수 있는지 확인한다 | 조회 상한은 있는데 다음 페이지가 없음 |
| 독립된 전체 글 경로 | 카테고리와 별개로 발행 글 전체를 링크하는지 확인한다 | 카테고리 경로 하나에만 의존함 |
이 표에서 핵심 신호는 홈에 20편만 보인다는 사실이 아니었다. 카테고리 조회도 20편에서 멈췄고 그 뒤로 넘어가는 페이지가 없으며, 카테고리 밖의 전체 글 경로도 없었다는 조합이었다. programming 글 수가 마침 20편이어서 현재 화면은 완전해 보였지만, 21편째 결과를 수용할 자리가 없었다.
코드에서도 원인은 작았다. 홈 목록에 필요한 20편 제한을 카테고리 조회에 그대로 재사용한 것이 전부였다. 각각의 화면만 보면 홈은 최신 글을 보여 주고, 카테고리는 보유한 20편을 모두 보여 줬다. 데이터가 20편을 넘기 전에는 누락을 재현할 수 없으니 코드 리뷰와 화면 확인 모두 통과하기 쉬웠다. 그래서 현재 개수만 세는 데서 멈추지 않고 상한보다 한 편 많은 상태를 가정해야 했다.
고친 방법: 카테고리 상한을 없애고 독립 경로를 더하기
첫 번째 수정은 카테고리 페이지의 20편 상한을 없애는 일이었다. 한 번에 임의의 큰 수를 요청하는 대신 페이지 단위로 조회해 결과를 이어 붙이도록 바꿨다. 발행 글이 20편을 넘어도 다음 결과를 계속 가져오므로 가장 오래된 글이 목록 밖으로 밀리지 않는다. 홈의 최신 20편 제한은 방문자에게 새 글을 먼저 보여 주는 역할이 분명해서 그대로 뒀다.
두 번째 수정은 발행한 글 전부를 카테고리별로 묶어 나열하는 `/archive` 페이지를 만들고, 그 링크를 모든 페이지의 푸터에 넣는 일이었다. 아카이브는 카테고리 조회와 별개로 모든 글을 상한 없이 모은다. 푸터는 홈·글·카테고리·about 화면에 공통으로 나오므로 어느 화면에서든 한 번의 클릭으로 아카이브에 닿는다. 아카이브에서 글까지 한 번을 더 거치기 때문에 홈에 직접 걸리지 않은 글의 클릭 수는 수정 전과 같은 두 번이다.
이 구성을 택한 목적은 크롤 깊이를 바꾸는 데 있지 않았다. 카테고리 페이지의 페이지네이션은 원래 경로가 글 수 증가에도 유지되게 만들고, 아카이브는 카테고리 소속과 무관한 두 번째 경로를 제공한다. 한쪽 구현에 상한이 다시 생기더라도 다른 쪽에서 전체 글 링크를 확인할 수 있다. 수정의 효과는 상한 제거와 경로 의존성 축소로 측정해야 했다.
새 사이트맵에도 `/archive`를 추가했다. `priority` 값은 0.7, `changefreq`는 weekly로 지정했다. 글이 새로 발행될 때마다 이 페이지 내용이 바뀌니 갱신 주기를 명시해 두는 편이 맞다고 판단했다.
링크를 놓을 자리로 푸터를 고른 이유도 따로 있다. 상단 내비게이션은 화면 크기나 디자인 개편에 따라 항목 구성이 달라질 수 있다. 반면 푸터는 공통 레이아웃에 들어 있어서 각 페이지가 개별적으로 아카이브 링크를 추가할 필요가 없다. 이번 실측에서도 홈·글·카테고리·about 전 페이지에 `/archive` 링크가 존재했다. 허브 페이지 자체의 깊이는 어느 페이지에서든 1로 확인됐다.
배포 뒤 발행 글 43편을 기준으로 다시 셌다. 홈에서 직접 링크되는 글은 21편, `/archive`가 링크하는 글은 43편, 사이트맵 URL은 52개였다. 카테고리별 링크는 programming 21편, llm-usage 13편, life 9편으로 합계 43편이었다. 특히 programming이 20편에서 멈추지 않고 21편을 모두 보여 준 결과는 카테고리 상한이 제거됐다는 직접 증거였다.
여기에 곁들여 `/llms.txt`(AI 답변엔진이 사이트 구조를 빠르게 파악하도록 요약한 파일)를 추가하고, robots.txt에 AI 크롤러 10종의 접근을 명시적으로 허용했다. 다만 이건 이번 작업의 곁가지였다. 카테고리 목록 상한과 내부 링크 경로를 고친 조치와는 별개라 여기서 더 자세히 다루지는 않는다.
사이트맵은 URL 목록이고 내부 링크는 실제 탐색 경로다. 이번 수정 뒤에는 사이트맵의 52개 URL과 별도로, 발행 글 43편이 카테고리와 아카이브 양쪽에서 모두 연결되는지 확인할 수 있게 됐다. 이 수치는 경로가 유지된다는 구조 검증 결과일 뿐, 크롤 빈도나 색인 결과를 보여 주는 값은 아니다.
남은 숙제: 아직 색인 변화는 관찰하지 못했다
배포한 지 얼마 되지 않아서, 이 조치로 검색 노출이나 색인 수가 실제로 늘었는지는 아직 확인할 수 없다. 확인한 것은 구조뿐이다. `/archive`가 43편 전부를 링크하고, 카테고리 세 곳의 링크 합계도 43편이며, programming 목록이 기존 상한을 넘어 21편을 표시한다. 검색 결과가 어떻게 움직일지는 시간이 더 지나야 알 수 있다.
구글이 내부적으로 크롤 자원을 정확히 어떻게 배분하는지는 공개된 정보만으로 단정할 수 없다. 내가 확실히 말할 수 있는 건 이 범위까지다. 내부 링크는 크롤러가 새 페이지를 찾는 주요 경로 중 하나이고, 사이트맵은 그 경로를 보완할 뿐 대체하지 않는다는 것. 그 이상의 주장은 이번 작업이 뒷받침해 주지 못한다.
다음으로 확인할 일은 정해져 있다. 몇 주 뒤 검색 콘솔에서 수정 전후의 색인 상태와 크롤 기록을 비교한다. 다만 이번 점검에서는 링크가 빠진 글이 실제로 발생하기 전에 수정했으므로, 색인 수가 늘지 않더라도 구조 수정이 실패했다는 뜻은 아니다. 관련해서 예약 발행 상태를 다룬 글도 배포 뒤 실측을 따로 남겼다. 이번에도 구조 검증 수치와 검색 결과 관찰을 섞지 않고 기록할 생각이다.
지금 이 시점의 결론은 programming 카테고리가 20편 상한을 넘어 21편을 표시하고, 43편 모두가 카테고리와 아카이브에서 링크된다는 데까지다. 다음 글에서는 이 구조 수치와 분리해 색인 상태가 실제로 바뀌었는지, 아니면 그대로인지를 있는 그대로 적을 생각이다.
자주 묻는 질문
사이트맵에 URL이 있으면 구글이 반드시 색인하나요?
아니다. 사이트맵은 그 URL이 존재한다는 신호를 전달할 뿐, 색인을 보장하는 문서가 아니다. 실제 발견과 방문은 크롤러가 내부 링크를 따라가는 경로에도 크게 의존한다.
홈 화면에 글 목록이 있으면 발견 경로로 충분한가요?
홈이 최신 글 일부만 링크하고 페이지네이션이 없다면 충분하지 않다. 이 사례에서는 38편 중 20편은 홈에서 직접 닿았고, 나머지 18편은 카테고리 페이지를 거쳐 두 번의 클릭으로 닿았다.
카테고리 페이지가 전부를 링크하면 문제가 없나요?
카테고리 페이지가 전부를 링크하는 동안에는 모든 글에 닿을 수 있다. 다만 목록에 20편 같은 상한이 걸리면 다음 글을 발행할 때 오래된 글이 내부 링크에서 빠질 수 있으므로 상한과 페이지네이션을 함께 확인해야 한다.
카테고리 목록의 20편 상한은 어떻게 발견하나요?
카테고리별 발행 글 수와 실제 목록 링크 수를 비교한다. 글 수가 20에서 멈추고 다음 페이지 링크가 없다면 상한을 의심하고, 21번째 글을 추가한 테스트로 가장 오래된 글이 계속 노출되는지 확인한다.
아직 댓글이 없습니다.